不到 24 小时,新站被 Google 收录且被 AI 直接引用:我用开源 claude-seo 做完海外 SEO 与 GEO 的全过程
作者:刘老板(@leo_xiaolei)· 2026 年 11 月 6 日 · 上一篇:3 天,我和 Claude 一起上线了第一个出海产品
上一篇《3 天,我和 Claude 一起上线了第一个出海产品》发出来之后,后台私信和评论区问得最多的,反倒是最后那一节关于 SEO 与 GEO 的实操:
「刘老板,我的海外独立站也搭起来了,但往 Google 里一搜自己名字,连个影子都没有。去问 ChatGPT 和 Perplexity 更是查无此人。不花每个月上百美金买 Ahrefs 或 Semrush,我们写代码的独立开发者到底怎么把冷启动的 SEO 和 AI 搜索(GEO)做起来?」
说实话,在 11 月 5 日上午之前,我的 AI 演示稿工具 APS Deck(apsdeck.com) 在搜索引擎眼里也几乎是个「黑洞」。
当时网站刚刚部署上线,人用浏览器点开看一切正常。但我装上开源的 claude-seo 插件,让 Claude Code 对着代码仓库和线上环境做完第一次全站体检后,拉出来的清单让我倒吸一口凉气:
robots.txt和sitemap.xml被全局登录守卫拦截,直接302跳去了登录页。简体、繁体和英文三种界面语言共用同一个 URL(靠 Cookie 切换),不带 Cookie 的搜索引擎爬虫永远只能看到简体中文,英文版等于彻底隐身。
随便敲一个不存在的地址也返回
302 -> /login(最终状态码200),在 Google 眼里全站都是违规的「软 404(Soft 404)」。首页单页 HTML 体积高达 256 KB。原因是 3 张示例幻灯片封面被转成
base64硬塞进了 HTML,还顺手把将近 10 万字的全站工作台多语言字典一股脑序列化给了客户端。更致命的是品牌词撞车。去搜
APS AI presentation,排在前面的全是国外另一款叫 Auto Presentation Switcher 的会议室硬件切换器,搜域名apsdeck更是零结果。
当天下午,我和 Claude Code 在仓库里配合,顺着 claude-seo 给出的诊断报告一口气打完了 7 场代码手术,补齐了单元测试与 Playwright 端到端测试,然后把站点提交给了 Google Search Console 和 Bing Webmaster Tools。
不到 24 小时后,我打开 Google 搜了一下 site:apsdeck.com,看到了下面这张截图:
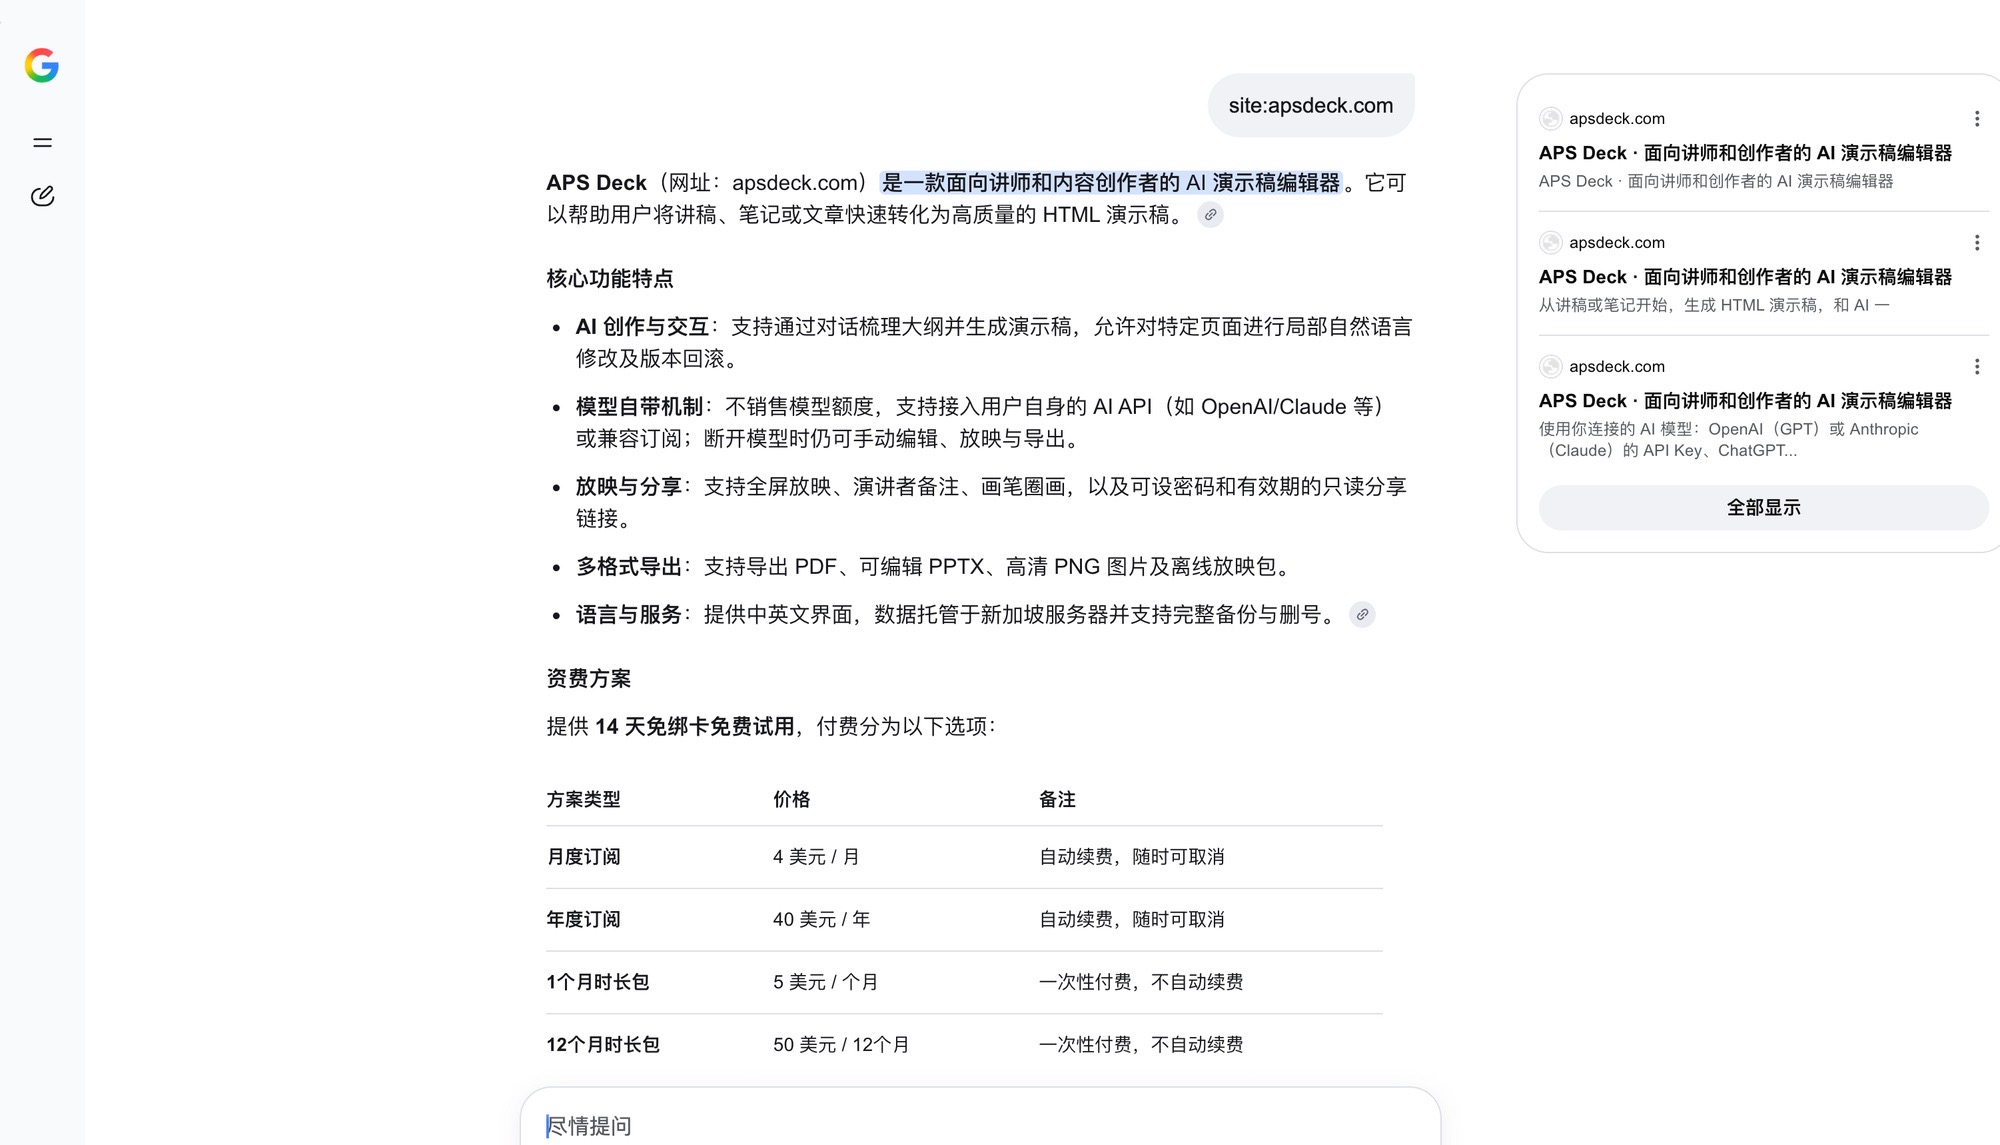
一个昨天才刚刚解析上线、外链数量为 0 的全新 .com 域名,已经被 Google 正式收录,展示出了我们改造后的标准品牌标题「APS Deck · 面向讲师和创作者的 AI 演示稿编辑器」。更让我意外的是,Google 搜索顶部的 AI 回答直接生成了一份结构工整的产品简报,从一句话定位、五大功能特点(包括 BYOK 自带模型、离线放映包与可编辑 PPTX 导出、新加坡数据托管),到底部四行一字不差的资费方案表格(月度订阅 $4/月、年度订阅 $40/年,以及 $5/月和 $50/年的一次性时长包,外加 14 天免绑卡免费试用),几乎就是把我们埋在首页常见问题(FAQ)和 SoftwareApplication 结构化数据里的文字原封不动摘录了出来!
全程没有买过任何付费 SEO SaaS 软件,也没有买过一条外链。
这篇文章,我把这次实战掰开揉碎讲透四件事:
底层逻辑:站在程序员视角,把 SEO(搜索引擎优化) 和 GEO(生成式 AI 引擎优化) 的运转机制与评分标准一次梳清。
工具拆解:开源插件 claude-seo(v2.5.0) 到底是怎么用「26 个子技能 + 19 个子智能体 + 本地确定性 Python 脚本」干活的。
代码实战:复盘
apsdeck.com的 7 场真实代码改造(附 Next.js 核心代码、架构取舍与自动化测试写法)。效果溯源与避坑:逐句拆解 Google AI 回答是怎么「抄作业」的,聊聊我对 AI 时代工程化 SEO 的理解,再把国内开发者必踩的「代理 TUN 模式假 IP(
198.18.x.x)导致检查全败」破局方案贴出来。
一分钟看完(核心结论速览)
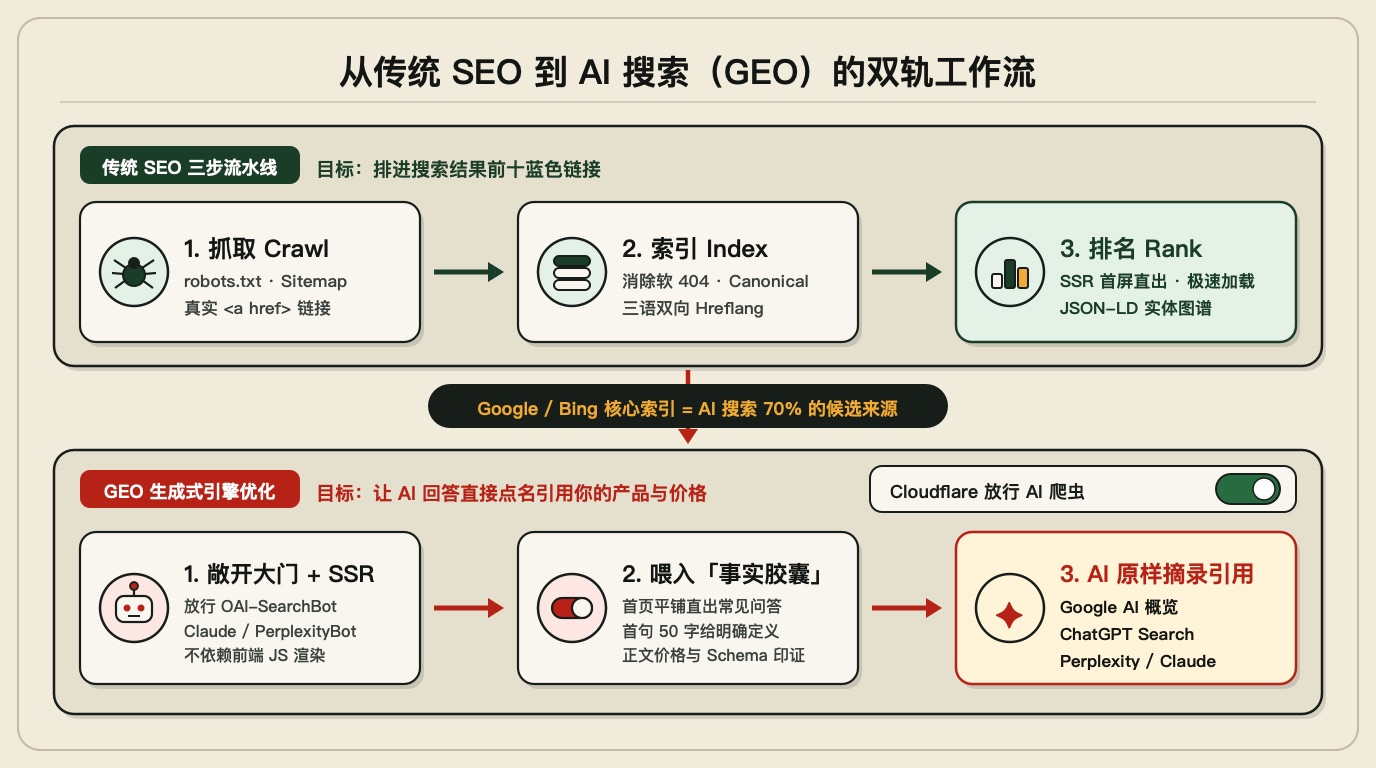
SEO 与 GEO 的真实关系:SEO 解决的是让传统搜索引擎抓得到、读得懂并排在前面。GEO(Generative Engine Optimization) 解决的是让各大 AI 搜索(Google AI 概览与 AI 模式、ChatGPT Search,以及 Perplexity 和 Claude Search)在生成回答时找得到你、提取得出事实,并且愿意点名引用你。Google 官方明确表态,从搜索引擎视角看,为生成式 AI 做优化本质上仍然是 SEO。先把 Google 和 Bing 的技术基建做扎实,GEO 就成功了 70%。
为什么用开源
claude-seo:它是 AgriciDaniel 开发的免费 Claude Code 插件(MIT 协议,v2.5.0 含 26 个子技能、19 个专家子智能体和 30 条命令)。它和每月 $100+ 的传统 SEO SaaS 最大的区别在于,事实由内置 Python 脚本实测而不靠大模型瞎猜,查完直接在你的代码仓库里改代码、生图片并补齐测试,还能通过PostToolUse钩子在每次改完文件后自动校验 JSON-LD 语法。apsdeck.com的 7 场实战改造:① 划清公开页与工作区边界,放开robots.txt/sitemap.xml,消除软 404,给私密分享加X-Robots-Tag: noindex。② 改造 Next.js 多语言路由为独立 URL(?lang=en/zh-Hans/zh-Hant)+ 双向hreflang+x-default,解决参数名冲突与局部刷新 Bug。③ 将公开品牌名统一为APS Deck并配置alternateName别名矩阵解决撞名。④ 剥离 base64 内嵌图与冗余语言包,首页 HTML 从 256 KB 骤降至 84 KB(瘦身 67%)。⑤ 构建@graph结构化数据图谱(含 4 档真实报价)并用 Playwright 自动渲染三语 1200×630 分享卡片。⑥ 首页直出 6 组「首句给结论」的事实胶囊问答,显式放行 10 大 AI 爬虫,同源动态生成/llms.txt并接入IndexNow自动推送。⑦ 用无 Cookie 的 Googlebot 上下文编写单元测试与 Playwright E2E 测试锁死防回退。实战效果:提交 Google Search Console 不到 24 小时即被收录,Google AI 回答精准提取并原样引用了产品定位、5 大功能点与 4 档价格表。
国内开发者必看避坑:在国内开着 Clash 或 Surge 等代理的 TUN 模式跑
claude-seo,域名会被劫持解析成198.18.0.x的 Fake-IP,直接触发插件的防 SSRF 内网拦截导致 100% 失败。文末附带用 DNS-over-HTTPS(DoH)+sitecustomize.py挂载解析钩子的完整破局代码。
一、先把底层逻辑打穿:为什么很多程序员写的网站,搜索引擎和 AI 根本「看不见」?
很多独立开发者(包括以前的我)都有个错觉,觉得只要网站部署上线、绑好域名,自己用 Chrome 打开能看到漂亮的界面,Google 和 ChatGPT 自然就能认识它。
其实人类用户在浏览器里看到的网页,和无状态的搜索引擎爬虫(Crawler)看到的网页,往往是两个完全不同的世界。
1. 搜索引擎工作的三道关卡:抓取 → 编入索引 → 排名
不管算法怎么演进,Google 和 Bing 处理任何一个网站都严格遵循三步流水线。只要前两步卡住,你的产品写得再惊艳,在搜索结果里也是查无此人:
| 关卡 | 搜索引擎在做什么 | 背后的工程逻辑 | 独立开发者最容易踩的致命坑 |
|---|---|---|---|
| 第一步:抓取(Crawl) | 爬虫(Googlebot / Bingbot)先请求 /robots.txt 看允许抓哪里,再顺着 /sitemap.xml 和页面里的 <a href> 链接逐个发起 HTTP 请求 | 新域名的抓取配额(Crawl Budget)极其有限。如果爬虫前几次来访问频繁碰壁或超时,就会大幅降低回访频率 | robots.txt 或 sitemap.xml 被中间件拦截跳去了登录页。Cloudflare 开了激进的防机器人盾(返回 403 验证码)。站内切语言或翻页只绑了 JS onClick 而没有真实的 <a href> |
| 第二步:编入索引(Index) | 解析抓回来的 HTML 源码,提取正文、标题与结构化数据,识别语言版本,剔除重复页,选定唯一的标准地址(Canonical URL)存入索引库 | 搜索引擎极度厌恶「歧义」和「重复」。同一份内容如果有多个 URL 却不声明以谁为准,权重就会被稀释甚至拒绝收录 | 软 404(Soft 404),即不存在的页面没返回 404 而是 302 跳到首页或登录页返回 200。多语言共用一个 URL 靠 Cookie 切换(爬虫永远只看到默认语言)。纯客户端渲染(CSR)导致原始 HTML 只有一个空 <div id="root"> |
| 第三步:排名与展示(Rank) | 用户发起检索后,按查询意图相关性、内容质量与可信度(E-E-A-T)以及页面核心体验(Core Web Vitals)打分排序,并生成搜索摘要或富媒体卡片 | 技术基建决定了你「能不能上牌桌」,而标题描述的精准度、结构化数据和品牌权威度决定了你「坐哪一桌」 | 页面没有 <meta name="description"> 导致 Google 随便抓取页脚杂文当摘要。品牌名叫通用缩写(如 APS)跟别家撞车。HTML 塞满 base64 图片拖垮首屏速度。违规编造虚假五星评分被人工处罚 |
所谓「技术 SEO(Technical SEO)」,管的就是前两步,扫清一切阻碍爬虫抓取和理解页面的工程障碍。
2. 独立开发者必查的技术 SEO 八大基建清单
结合这次改造 apsdeck.com 的经验,我把现代 Web 应用(尤其是 Next.js / Nuxt / Remix 这类全栈框架)上线海外时必须核对的技术基建浓缩成 8 条硬指标:
/robots.txt(爬虫交通指示牌):必须返回200 OK和text/plain。明确放行所有公开营销页与博客(Allow: /),同时用Disallow挡住需要登录的工作台(如/projects/和/settings)、后端接口(/api/)以及用户生成的临时链接。最后一行务必写明完整的Sitemap: https://你的域名/sitemap.xml。/sitemap.xml(公开页面的官方户口本):只放真正希望被收录且返回 200 的标准 URL(千万别把noindex的页面或重定向地址塞进 sitemap,这在claude-seo里属于高危扣分项)。支持多语言的站点,直接在 sitemap 的每个<url>节点下用<xhtml:link rel="alternate" hreflang="..." href="..." />声明所有语言版本的对应关系。<lastmod>(最后修改时间)要么不写,要写就填真实的文档或代码更新日期,如果全站所有页面每秒钟都动态生成当前时间当<lastmod>,会被 Google 直接判定为不可信而忽略。真实的 HTTP 状态码(消灭「软 404」):很多 SaaS 模板喜欢写一条兜底路由,凡是没匹配到的路径或者未登录的请求,统统
302重定向到/login或首页。爬虫请求/a-non-existent-page,经过跳转后拿到了/login的200 OK页面,Google 会发现无数个随机地址都返回同一份「请登录」的内容,从而判定你的站点存在大量 Soft 404(软 404),直接拖垮正常页面的收录速度。正确做法是只有明确属于工作区的功能路由(如/settings、/projects)未登录时才跳/login,其余一切未知路径必须干脆利落地返回真正的 HTTP404 Not Found。自引用
canonical(标准地址锚点):哪怕一个页面没有其他重复地址,也应该在<head>里写上指向自己的<link rel="canonical" href="...">(Self-referencing canonical)。一旦有人在推特或社群转发你的链接时带上了?utm_source=twitter或?ref=producthunt等统计参数,搜索引擎依然知道把权重集中归算到干净的标准地址上。双向闭环的
hreflang+x-default(多语言铁律):多语言网站绝不能只靠浏览器Accept-Language或 Cookie 在同一个 URL 下动态换文字,因为爬虫不存 Cookie。必须保证每种语言有自己独立的 URL(子路径/en/或查询参数?lang=en均可)。更关键的是hreflang必须双向互指(Bidirectional),如果英文页声明了「我的简中版是 B」,但简中页 B 里没有反过来声明「我的英文版是 A」,Google 会直接作废这条关系。同时别忘了加一条x-default指向不带语言参数或默认语言的入口。服务端渲染(SSR / SSG)与 HTML 体积预算:页面核心文案、标题、FAQ 和 JSON-LD 必须直接输出在首屏服务端返回的 HTML 源码里,不能等浏览器下载几兆 JS 执行完才渲染出来。保持首屏 HTML 干净轻量(建议控制在 100 KB–150 KB 以内),严禁把大图转成
data:image/...;base64直接内嵌进 HTML 文档。Core Web Vitals(核心网页指标):Google 重点考核三个真实用户体验指标,分别是 LCP(最大内容绘制,
≤ 2.5s为优)、INP(Interaction to Next Paint,交互到下一帧绘制,≤ 200ms为优,注意 Google 已正式用 INP 全面取代了老旧的 FID)以及 CLS(累计布局偏移,≤ 0.1为优)。比如我们在给/blog写图片渲染时,专门在服务端读取每张 JPEG/PNG 文件头部的真实宽高(width和height)直接写进<img width="..." height="...">,确保图片加载前后页面一像素都不会跳动(CLS = 0)。严密的
noindex隐私防线:登录页、后台管理页用<meta name="robots" content="noindex, nofollow">挡掉。用户生成的私密分享链接(如/s/<随机令牌>)或团队邀请链接(如/invite/<令牌>),除了在robots.txt里禁止抓取,还必须在服务端 HTTP 响应头里加上X-Robots-Tag: noindex, nofollow。因为一旦某个用户把分享链接发到了公开网页上,Google 顺着外链还是可能把它编入索引,唯有noindex响应头能彻底杜绝私人内容出现在搜索结果里。
3. 结构化数据(JSON-LD):给机器看的「高精度说明书」,以及 2026 年的两条红线
如果说 HTML 正文是写给人看的,那么放在 <script type="application/ld+json"> 里的 JSON-LD 结构化数据,就是用 schema.org 的标准词汇表直接喂给搜索引擎和 AI 的「结构化事实清单」。
在一个标准的 SaaS 独立站上,最核心的是用 @graph 把以下几个实体通过 @id 串联成一张完整的知识图谱:
Organization:声明网站背后的运营主体、Logo、官方网址与客服邮箱(@id: "https://apsdeck.com/#organization")。WebSite:声明网站的正式品牌名称(name)与备选别名(alternateName)。Google 搜索结果顶部显示的「站点名称」直接优先从这里读取。SoftwareApplication:声明软件类别(如BusinessApplication/Presentation software)、支持的操作系统以及核心功能(featureList),并用offers数组明确列出每一档套餐的真实价格与币种(price、priceCurrency: "USD")。BreadcrumbList:声明页面所处的面包屑层级(如首页 > 价格或首页 > 博客 > 文章标题)。BlogPosting:在技术博客文章页声明文章标题、发布日期(datePublished)、修改日期(dateModified)、作者信息与封面图。
写 JSON-LD 时有两条 2026 年必须严守的红线(这也是 claude-seo 的校验脚本会重点抓的):
红线一:只写页面上真实存在、能验证的事实,绝不捏造评分(
aggregateRating)和评论(review)。很多野路子教程会教你往SoftwareApplication里硬塞一段"aggregateRating": { "ratingValue": "4.9", "ratingCount": "888" }来骗取搜索结果里的金色五角星。千万别干!Google 对自我服务的虚假评分审核非常严,一旦触发人工或算法处罚(Manual Action),全站所有结构化数据展示资格都会被直接剥夺。红线二:别再浪费时间写
FAQPage结构化数据了! 很多大模型(因为训练语料滞后)直到今天还会建议你给常见问答加FAQPageSchema。根据claude-seo技能库同步的 Google 官方最新政策,Google 早在 2023 年 8 月就将 FAQ 富媒体展示限制在政府与医疗健康类权威网站,并自 2026 年 5 月 7 日起,在全网所有网站上彻底停用了FAQPage富媒体搜索结果! 现在普通商业网站加FAQPageJSON-LD 在 Google 搜索上没有任何展示收益。相反,把常见问答用清晰的 HTML<h3>问题 +<p>结论句直接写在页面正文里,对用户阅读和接下来的 GEO(AI 引用) 才是真正的大杀器。
二、GEO(生成式引擎优化):当用户不再点蓝色链接,怎么让 ChatGPT、Perplexity 和 Google AI 直接引用你?
过去两年,做海外产品的开发者都感受到了一个明显变化,用户的搜索习惯变了。
以前用户找工具,是在 Google 里敲词条 AI presentation maker,然后耐着性子点开前五个蓝色链接逐个对比。现在越来越多的人直接打开 ChatGPT、Perplexity 或 Claude,或者看 Google 搜索最顶部的 AI Overview(AI 概览)/ AI Mode(AI 模式),直接问一句:
「帮我找一个支持自带 OpenAI/Claude API Key、能把讲稿变成 HTML 幻灯片并导出可编辑 PPTX 的工具,顺便告诉我怎么收费?」
如果 AI 的回答里提到了你、给出了准确的价格并附上了你的官网链接,这就是最高质量的精准转化流量。研究怎么让生成式 AI 引擎读到你、读懂你并愿意引用你的整套方法论,就叫 GEO(Generative Engine Optimization,生成式引擎优化)。
1. GEO 和传统 SEO 到底是什么关系?别被概念忽悠了
现在市面上有很多卖课或卖工具的人把 GEO 包装得神乎其神,好像传统的 SEO 已经死了、必须搞一套全新的玄学才行。
Google 在 Search Central 官方文档里说得很明确,从 Google 搜索的角度看,为生成式 AI 搜索体验做优化,就是为搜索做优化,因此本质上仍然是 SEO。 claude-seo 的 seo-geo 模块也严格遵循了一条「官方来源优先原则(Source Hierarchy)」,SEO 社区的流行传言与 Google Search Central 的一手文档冲突时,无条件以 Google 一手说法为准。
为什么这么说?看一眼当今四大主流 AI 搜索引擎的底层检索管线(RAG Pipeline)就全明白了:
Google AI Overviews & AI Mode:直接建立在 Google 核心搜索索引之上,由 Gemini 模型对排名前列且高相关度的网页片段进行事实提取与综合汇总。
ChatGPT Search(OpenAI):采用混合检索架构,一方面直接调用 微软 Bing 的搜索索引,另一方面派出自家的搜索爬虫
OAI-SearchBot建立独立索引,并在用户对话中实时触发ChatGPT-User抓取网页。Perplexity:依靠自家的
PerplexityBot持续抓取全网公开页面构建实时向量与关键词索引。Claude Web Search(Anthropic):通过
Claude-SearchBot和用户触发的Claude-User获取实时网页正文。
看懂了这张底牌,你就明白为什么说 「先把 Google 和 Bing 的技术 SEO 做扎实,你的 GEO 就已经成功了 70%」。要是连 Google 索引和 Bing 索引都没进,主流 AI 搜索在进行第一轮候选召回(Retrieval)时根本就不可能捞到你的网页!
剩下的 30%(也就是 GEO 真正多出来的那部分工作),只看两件事:第一,你的大门有没有向 AI 爬虫敞开且返回纯文本 HTML?第二,你网页上的文字写法,方不方便大模型直接「摘抄成答案」?
2. AI 爬虫的「两大家族」与 Cloudflare 隐形拦截大坑
很多站长在配 robots.txt 时,听网上说「AI 会白嫖你的网站内容去训练模型」,于是顺手把所有带 Bot、GPT 或 Claude 字样的爬虫全封了。结果过了一个月纳闷:「为什么 ChatGPT 搜索和 Perplexity 死活搜不到我的产品?」
实际上,各大 AI 巨头的网络爬虫严格分成了两大家族(外加用户实时触发类),职责完全不同,千万不能一刀切:
| 爬虫类别 | User-Agent 标识 | 所属公司 | 真实用途与对你的影响 | 独立站建议策略 |
|---|---|---|---|---|
| 第一类:AI 搜索引用爬虫 (Search & Citation Bots) | OAI-SearchBot | OpenAI | ChatGPT 搜索的直接来源:决定你的网站能不能出现在 ChatGPT 搜索结果和引用链接里 | 必须放行(公开页面) |
| 同上 | Claude-SearchBot | Anthropic | Claude 联网搜索的索引来源:决定 Claude 搜索回答时能不能引用你 | 必须放行 |
| 同上 | PerplexityBot | Perplexity | Perplexity 的搜索索引来源:决定能不能进入 Perplexity 的参考来源卡片 | 必须放行 |
| 第二类:用户实时访问代理 (User-Triggered Fetchers) | ChatGPT-User / Claude-User | OpenAI / Anthropic | 用户在对话框里直接贴入你的网址、让 AI「帮我看看这个网站讲什么」时发起的实时抓取 | 必须放行 |
| 第三类:大模型预训练爬虫 (Model Training Crawlers) | GPTBot / ClaudeBot / Google-Extended / Applebot-Extended / CCBot | OpenAI / Anthropic / Google / Apple / Common Crawl | 用于收集语料训练下一代基座大模型(其中 Google-Extended 是一个权限开关而非独立爬虫,控制内容能否用于训练 Gemini,不影响 Google 搜索与 AI 概览展示) | SaaS 官网建议一并放行;付费内容媒体可按需禁止 |
我们做 SaaS 工具的独立开发者,公开页面本来就是产品功能介绍、定价说明和服务条款,巴不得全世界的模型基座都把我们的产品记进脑子里。所以在 apsdeck.com 上,我把这 10 个爬虫在公开页面上全部显式放行,只挡住工作台和 API。
这里有两个极易翻车的工程细节:
Cloudflare 的「拦截 AI 爬虫」隐形开关:Cloudflare 从 2025 年起对新接入的域名,有可能会在后台开启
Block AI bots(AI 爬虫控制)或者开启Managed robots.txt(托管型 robots.txt,会在你自己写的robots.txt最前面强行插入一段禁止 AI 爬虫的规则)。如果 Cloudflare 层面拦了,你在代码里把robots.txt写出花来都没用!上线后务必去 Cloudflare 后台的Security -> Settings / Bots(或AI Crawl Control)里确认这两个开关处于关闭状态。大多数 AI 爬虫根本不执行 JavaScript! Googlebot 之所以能看懂一部分 React/Vue 单页应用,是因为 Google 养了一套极其昂贵的无头浏览器渲染集群(Web Rendering Service)。但
claude-seo的技术文档明确指出,像GPTBot、OAI-SearchBot以及ClaudeBot和PerplexityBot这些 AI 爬虫,绝大部分时候只发起纯 HTTP GET 请求读取原始 HTML,完全不执行客户端 JavaScript! 这意味着如果你的产品介绍和价格表要靠前端 JS 异步请求渲染,AI 爬虫抓回去的就是一页空白。服务端渲染(SSR)是 GEO 的绝对生命线。
3. 拆解 claude-seo 的 GEO 五维评分模型:什么样的内容最受大模型偏爱?
爬虫顺利拿到 HTML 后,大模型在把几十个网页浓缩成一段几百字的 AI 回答时,最喜欢引用什么样的段落?
claude-seo 的 seo-geo 子技能把 AI 搜索就绪度拆解成了 5 个量化评分维度(总分 100%)。我第一次读完它的评分规则时恍然大悟,这简直就是一份为技术写作者和产品经理量身定制的「高引用率写作指南」:
| 评分维度 | 权重占比 | 大模型在找什么? | 落地到网页与文章上的具体写法 |
|---|---|---|---|
| 1. 可引用性 (Citability) | 25% | 能不能不改一个字、直接把你的一句话复制进回答里当结论? | 结论前置(Answer-First):每个小节或每个问答的开头 40–60 个字内直接给出完整结论。多用「X(别名 Y,网址 Z)是一个面向 A 的 B 工具,支持 C,价格为 D」的标准定义句,写出具体的数字、日期和配置,少用空洞的形容词 |
| 2. 结构可读性 (Structural Readability) | 20% | 网页的 DOM 树是不是清晰的「问题 → 答案 / 对比表格 / 步骤列表」结构? | 严格保证全文只有 1 个 H1,下辖清晰的 H2、H3。小标题尽量写成用户会直接在对话框里问的疑问句(如「APS 多少钱?要自己准备模型吗?」)。多方案对比用 <table>,操作步骤用 <ol>/<ul>,在首页直接放一组常见问答(FAQ) |
| 3. 技术可访问性 (Technical Accessibility) | 20% | AI 爬虫能不能毫无阻碍地在 1 秒内拿到干净的 HTML 正文? | 100% 服务端渲染(SSR)直出正文,robots.txt 与 CDN 放行搜索类 AI 爬虫,剔除冗长的内联 base64 与无用脚本,提高 HTML 的「有效文本信噪比(Text-to-HTML Ratio)」 |
| 4. 权威与品牌提及 (Authority & Brand) | 20% | 这个说法是谁写的?可靠吗?全网别的地方有人讨论这个品牌吗? | 文章写明真实作者、社交账号链接以及发布与更新日期,引用一手官方来源,积极在外部社区建立品牌提及(Brand Mentions) |
| 5. 多模态与结构化 (Multi-Modal & Schema) | 15% | 除了纯文字,有没有机器能秒懂的 JSON-LD 账本和带说明的配图? | 配置严谨的 Organization、WebSite 与 SoftwareApplication(带真实 Offer 价格)及 BlogPosting 结构化数据,每张图片配齐描述清楚核心信息的 alt 文本 |
为了让大家直观感受到什么叫「高可引用性(Citability)」,我们直接拿 apsdeck.com 首页的写法做个对比。
❌ 传统自嗨型 SaaS 黑话(AI 完全无法提取有效事实,直接跳过):
「APS 是新一代颠覆性的 AI 原生演示文稿生产力平台。我们致力于通过前沿大模型技术赋能全球讲师与创作者,打破传统排版桎梏,提供极致丝滑的幻灯片生成体验,并以极具竞争力的灵活订阅价格助力您的每一次精彩演讲。」
✅ 改造后写入 apsdeck.com 首页 FAQ 的「事实胶囊(Fact Capsule)」(AI 直接原样抄进回答):
「APS(也叫 APS Deck,网址 apsdeck.com)是什么?
APS(也叫 APS Deck,网址 apsdeck.com)是一个面向讲师和内容创作者的 AI 演示稿编辑器:给它一份讲稿、笔记或文章,AI 先问你几个关于听众和目的的问题,列出大纲,再一页页做成 HTML 演示稿;之后可以让 AI 改,也可以自己改,在网页里放映、生成分享链接,或者导出 PDF 和可编辑的 PPTX。」
「APS 多少钱?
订阅每月 $4 或每年 $40,随时可以关掉自动续费;不想自动续费,也可以买一次性时长包:1 个月 $5、12 个月 $50。新账号免费试用 14 天,不用绑卡。」
回看文章开头那张 Google AI 回答的截图,段落只要主谓宾齐全、数字精确又没废话,大模型根本没有任何抵抗力,直接整段搬走并自动帮你排成了漂亮的要点列表和价格表格!
第四个维度「权威与品牌提及」里,claude-seo 还引用了 Ahrefs 对 7.5 万个品牌做的一项大规模研究结论,非常值得所有出海开发者警醒:
在生成式 AI 搜索中,「品牌在全网被提及的次数(Brand Mentions)」与 AI 可见度的相关性,是传统外链(Backlinks)的 3 倍以上!
大模型判断一个新工具值不值得推荐,看的不仅是你有多少条死板的外链,更看重你的品牌名(比如 APS Deck 和 apsdeck.com)有没有在 Reddit、X(Twitter)或 Hacker News,以及 YouTube 视频简介和技术博客里被真实的人讨论和提及。
4. /llms.txt 要不要做?神话与现实
最近半年,开发者圈子里很流行聊 /llms.txt(llmstxt.org 提出的一项社区规范),做法是在网站根目录放一个纯 Markdown 格式的 /llms.txt 文件,把网站的产品介绍、价格和主要页面链接浓缩在一页里,设想是方便大模型直接读取。
关于它,我们要有清醒的工程认知:
Google 官方人员已经明确表态,Google 搜索和 AI 概览不使用
llms.txt。claude-seo的报告里也只把llms.txt当作「智能体友好度(Agentic Readiness)」的一项存在性检查,不给它在 GEO 评分里算高分。
那我为什么还是在 apsdeck.com/llms.txt 上做了它?
第三方 AI 编程助手、自定义 Agent 或用户手动喂给大模型时,一页干净的 Markdown 说明书确实很方便。更重要的是,我用了一个「零维护成本」的偷懒巧思,没手写静态的 llms.txt,直接写了一个动态路由 src/app/llms.txt/route.ts,读取首页的 landing.json 多语言文案和后端的 PLANS 价格配置常量自动拼接生成! 这样既花不了 50 行代码,又永远不会出现「改了价格却忘了改 llms.txt,导致跟网页正文说法打架」的乌龙。
三、深度拆解开源 claude-seo(v2.5.0):为什么它比「直接问 AI」和「传统 SEO 工具」强得多?
很多朋友会问,「既然我已经开了 Claude Code,直接在对话框里跟 Claude 说一句『帮我检查并优化一下这个项目的 SEO』不就行了吗?为什么要专门装一个 claude-seo 插件?」
这恰恰触及了 AI 辅助编程从「玩具」走向「专业工业级工具」的核心痛点。
1. 直接让裸模型看 SEO 的三大硬伤
如果你不装插件、直接让通用大模型去检查网站 SEO,通常会撞上三个硬伤:
事实全靠「脑补」与静态盲猜:裸模型只会低头翻你的源码文件,它不会真的用无头浏览器去跑一遍渲染,不会去实测
/robots.txt会不会发生 302 跳转,更不会伪装成OAI-SearchBot去测试 Cloudflare 有没有返回 403 拦截。领域知识滞后且零散:大模型的预训练知识是有截止日期的,而且容易被网上过时的营销水文污染。比如它依然会兴致勃勃地帮你写早就作废的
<meta name="keywords">和FAQPageSchema,或者漏掉 2025–2026 年新出来的 AI 搜索爬虫标识。单智能体上下文爆炸:一个完整的全站 SEO 审计涵盖技术抓取、多语言矩阵与 JSON-LD 语法,还要兼顾 Core Web Vitals 性能、E-E-A-T 内容质量和 GEO 可引用性六七个正交维度。让一个主对话窗口同时干完这些事,上下文很快就会混乱、挂一漏万。
2. claude-seo 的三层工程架构拆解
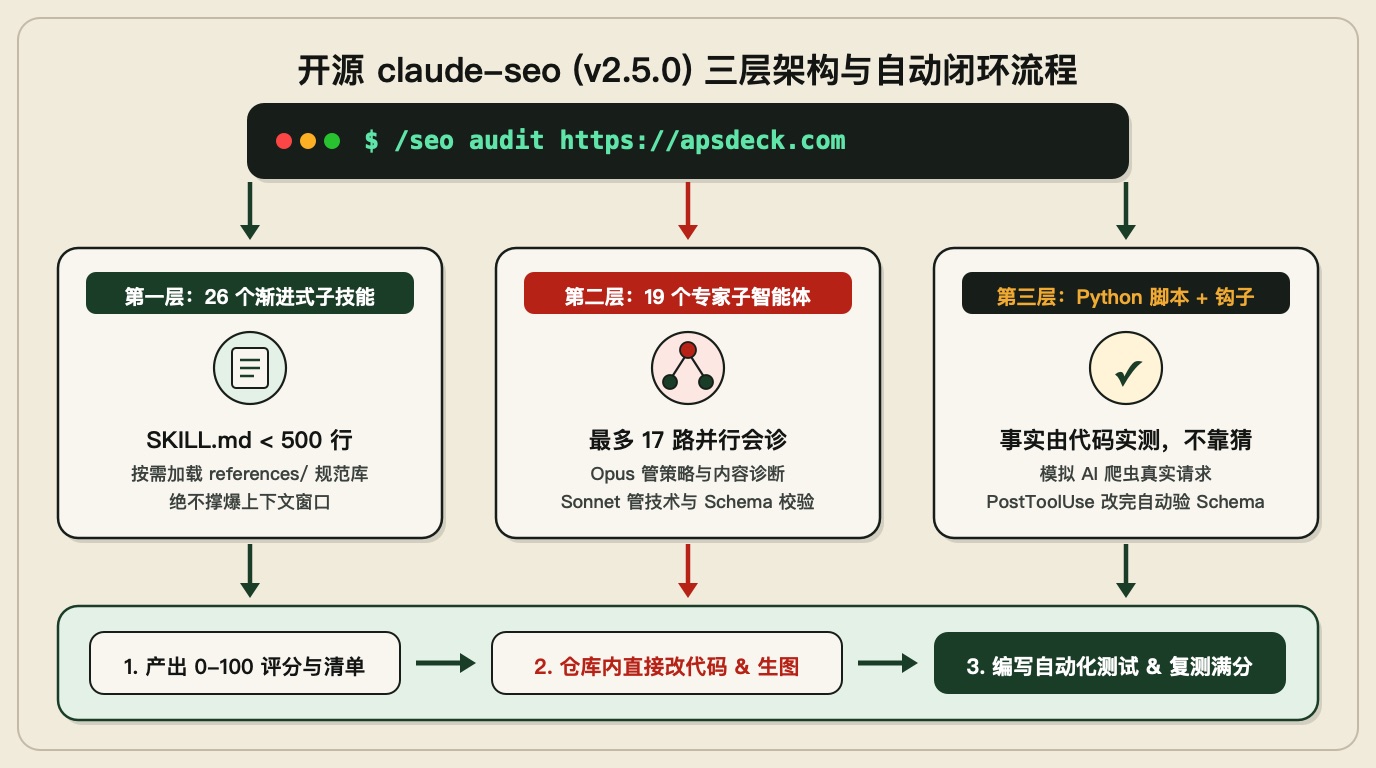
claude-seo(作者 AgriciDaniel,MIT 开源协议)之所以在 GitHub 上大受欢迎,正是因为它用一套教科书式的 Agent Engineering(智能体工程)三层架构,把上面三个硬伤挨个解决了。
我这次用的是 v2.5.0 版本,拆开它的源码目录,可以看到清晰的三层分工:
第一层:渐进式披露技能层(26 个子技能 skills/,守住上下文预算的活字典)
插件一共包含 26 个子技能(22 个核心领域技能 + 1 个 seo 总调度 + 1 个框架技能 + 2 个扩展技能)和 30 条 /seo 斜杠命令。它的目录设计非常聪明,叫「渐进式披露(Progressive Disclosure)」:
主文件精简控长:每个技能的主说明文件
SKILL.md严格控制在 500 行以内,只写最核心的检查流程、评分权重和红线规则。规范库按需加载:那些动辄几千行的 schema 模板、各行业细分规范以及 Google 最新算法变更说明,全部拆放在同目录的
references/文件夹下,只有智能体在检查中确实遇到对应问题时才按需读取(On-demand loading)。哪怕同时激活多个技能,也绝不会撑爆 Claude 的上下文窗口。
第二层:分层模型路由的专家智能体层(19 个子智能体 agents/,并行会诊)
敲下 /seo audit https://apsdeck.com 后,总调度(Orchestrator)会先识别你的网站属于哪一类业务原型(SaaS 软件、电商或内容媒体等),然后像医院多学科会诊一样,一次性并行派出最多 17 个专家子智能体同时开工:
/seo audit https://apsdeck.com
  └─ seo(总调度 Orchestrator):识别站点类型为「SaaS 独立站」
      ├─ 第一梯队(必派 7 路核心专家并行执行):
      │   ├─ seo-technical   (抓取、索引、状态码、重定向、安全头等 9 大类)
      │   ├─ seo-content     (E-E-A-T 权威度、可读性、薄弱内容检测)
      │   ├─ seo-schema      (JSON-LD 探测、语法与 Google 规范校验、生成方案)
      │   ├─ seo-sitemap     (XML 结构、死链混入、lastmod 真实性、hreflang 核验)
      │   ├─ seo-performance (Core Web Vitals:LCP / INP / CLS 与 HTML 载荷体积)
      │   ├─ seo-visual      (无头浏览器实机截图、首屏视觉层级与移动端适配)
      │   └─ seo-geo         (AI 搜索五维评分、AI 爬虫放行、llms.txt 与品牌提及)
      ├─ 第二梯队(按条件自动加派):
      │   └─ seo-hreflang(检测到多语言)、seo-google(配了 API 凭据)、seo-drift(对比历史快照)……
└─ 汇总引擎 → 输出 0–100 综合健康分 + 按优先级(Critical / High / Medium / Low)排好的行动清单更讲究的是它的模型分层路由(Tiered Model Routing):
Claude Opus 负责深度推理与内容诊断:需要深度语义理解、跨维度权衡和内容质量评判的智能体(如总体策略、E-E-A-T 内容诊断与 GEO 可引用性分析),路由给推理能力最强的 Claude Opus。
Claude Sonnet 负责高频规范核验与代码生成:需要严格对照技术规范做高频解析和代码生成的智能体(如 Technical、Schema、Hreflang、Sitemap 和 Performance),路由给速度快、性价比高的 Claude Sonnet。
四要素行动清单直通施工:它最后汇总出来的行动清单,每条都写明四个要素(判断依据是什么 → 依赖什么前置条件 → 具体怎么改代码 → 改完后跑哪条命令验证已经修好),直接喂给主对话里的 Claude Code 就能一键施工。
第三层:确定性 Python 脚本与防呆钩子层(scripts/ & hooks/,事实由代码测,绝不靠模型猜)
这是整个插件含金量最高的一层。claude-seo 自带了一整套 Python 脚本(配合独立的虚拟环境和 Playwright Chromium):
真实 HTTP 探测与 DOM 解析:它去检查页面标签、发现 Sitemap,或者伪装成
OAI-SearchBot/ClaudeBot/PerplexityBot请求你的网站、校验 JSON-LD 结构以及检查llms.txt是否符合 Lighthouse 规范时,全部是由 Python 脚本发起真实的 HTTP 请求并解析 DOM 拿到精确数据,再把结构化的铁证交给大模型做判断。PostToolUse自动 Schema 校验钩子:插件在 Claude Code 的Edit和Write工具后挂载了一个自动钩子。每当 Claude Code 修改或新建了包含 JSON-LD 的代码文件,钩子会在后台瞬间跑一遍语法和合规校验。要是模型手滑写漏了一个引号,或者误加了已废弃的FAQPage,当场就会报错提醒重改,根本等不到上线!防 SSRF 的固定 DNS 安全网络层:插件里所有负责抓取网页的脚本,底层都包了一层严格的安全检查。脚本会先固定解析 DNS,一旦发现目标 IP 属于本机回环(
127.0.0.0/8)、局域网私有地址(10.0.0.0/8、192.168.0.0/16)或保留地址段(如198.18.0.0/15),立刻拒绝连接以防止服务端请求伪造(SSRF)攻击。(注:这个安全设计非常专业,但也会带来两个现象:一是它不直接测localhost未上线地址,二是国内开发者开着 Clash/Surge 的 TUN 假 IP 模式时会全军覆没。第六部分我会给出几行代码的破局方案!)
3. 三步安装与高频命令速查表
在 Claude Code 里安装 claude-seo 只需要两条命令(建议直接装在用户级,这样你电脑上的所有项目都能随时调用):
# 1. 添加作者的插件市场源并安装 claude-seo
/plugin marketplace add AgriciDaniel/claude-seo
/plugin install claude-seo@agricidaniel-claude-seo

# 2. 首次使用前初始化独立 Python 虚拟环境与 Chromium(不污染系统环境)
/seo setup

# 3. 随时检查运行环境与依赖是否就绪(只读检查,不改任何文件)
/seo doctor
日常开发与上线复测最常用的命令清单:
| 命令 | 适用场景与核心作用 |
|---|---|
/seo audit <网址> | 上线后全站大体检:并行派出多路专家子智能体,产出综合健康分与分优先级的完整修复清单 |
/seo page <网址> | 单页深度解剖:针对落地页(Landing Page)或核心转化页做标签、正文、Schema 与性能全方位透视 |
/seo technical <网址> | 技术 SEO 专项检查:聚焦抓取权限、索引标签、重定向链、状态码、Canonical 及安全响应头等 9 大类 |
/seo schema <网址> | 结构化数据专家:检测页面现有 JSON-LD,按 Google 2026 最新规范校验报错,并生成可直接粘贴的代码 |
/seo hreflang <网址> | 多语言出海必跑:校验各语言版本的双向互指闭环、x-default 兜底及 ISO 语言代码合法性 |
/seo geo <网址> | AI 搜索(GEO)专项体检:按五维模型给页面打分,检查 AI 爬虫放行状态、事实胶囊密度与品牌信号 |
/seo agentic <网址> | AI 智能体友好度检查:测试各家 AI 爬虫能否顺利抓取、检查 /llms.txt 与 Markdown 内容可提取性 |
/seo sitemap <网址> | 站点地图诊断与生成:检查现有 XML 是否有死链/重定向混入,或根据站点结构生成标准 Sitemap |
/seo content <网址> | 内容质量与 E-E-A-T 评估:分析文章或落地页的专业度、原创信息量、作者背书与可读性结构 |
/seo drift <网址> | SEO 防回退快照对比:给当前健康的线上站点拍一张基线快照,日后发版后再跑一次即可揪出改坏的标签 |
/seo google | 对接 Google 官方接口:连接 Search Console、PageSpeed Insights、CrUX 真实用户体验数据(需配 API Key) |
(注:插件还支持按需接入 DataForSEO、Ahrefs 或 SE Ranking 等付费外部扩展来拉取竞品外链和词表搜索量。就算一个外部扩展都不接,上面这套核心体检和改代码能力也是 100% 免费可用的。)
四、结合案例的深度实战:我是怎么用 claude-seo 把 apsdeck.com 从「搜索黑洞」改成「满分基建」的?
APS Deck 是用 Next.js(App Router)+ TypeScript 写的全栈应用。项目最初是从本地自部署版(Self-hosted)演进而来的,所以在 11 月 5 日刚推上新加坡生产服务器时,整个网站的路由和渲染逻辑完全是按「内部工作台工具」设计的。
当时我对 Claude Code 下达的指令非常直接:
「用
claude-seo的规则和脚本把项目的整个 SEO 和 GEO 做好、测试好,做到完美之后提交代码,告知我去部署。」
这 7 场代码级改造手术是一个下午连续做完的,下面这张图汇总了改造前后的核心指标对比:
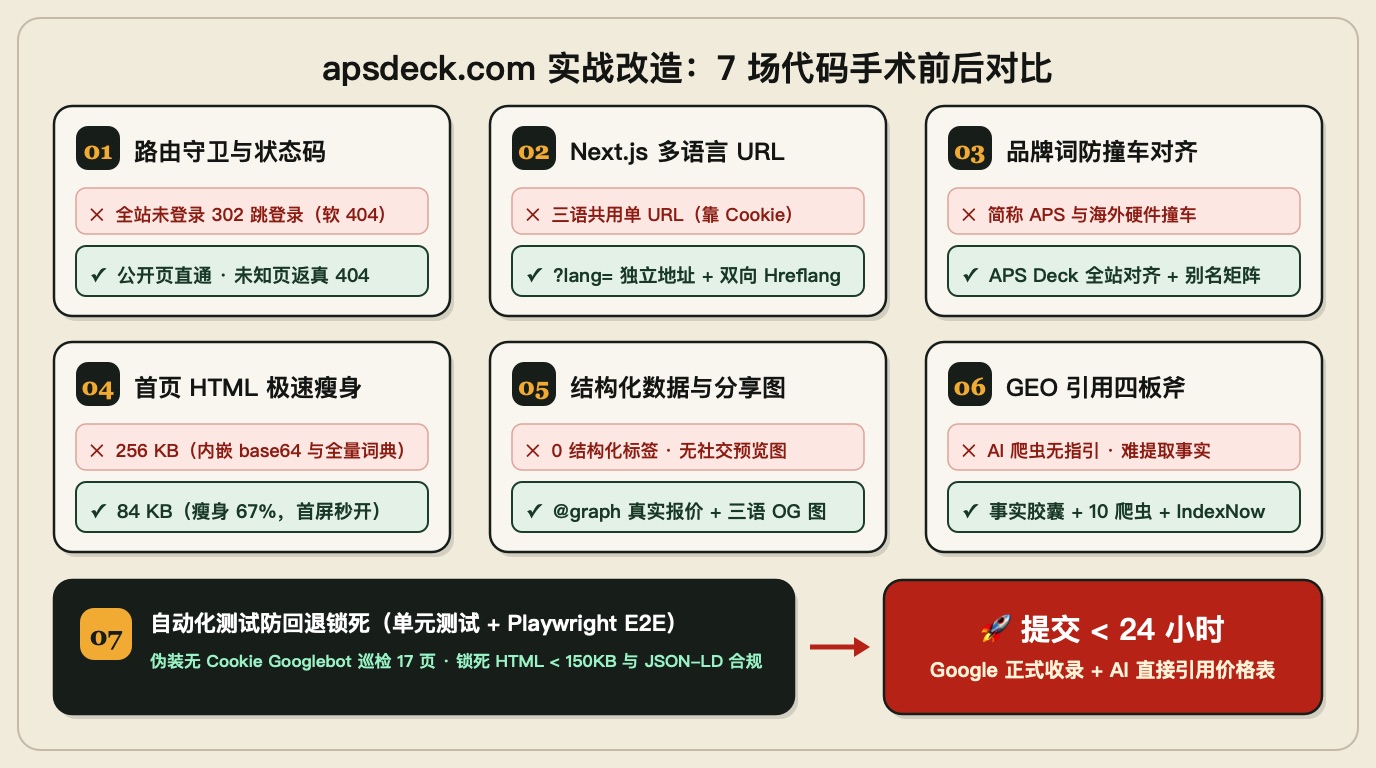
下面我把这 7 场手术每一场遇到了什么坑、架构怎么权衡以及实际代码怎么写,逐一拆开给大家看。
手术一:打破「全站跳登录」的软 404 困局,划清公开与私密的铁边界(proxy.ts)
查出的病灶:在最初的请求守卫(src/proxy.ts)里,逻辑很粗暴,除了 /login 和 /api/health,任何未携带登录态 Session Cookie 的请求,一律 302 重定向到 /login。这导致了三个灾难性后果:
拦截规则文件:爬虫去读
/robots.txt和/sitemap.xml,直接被302跳到了/login,根本拿不到规则文件。全站软 404:外部访客或爬虫随便访问一个拼写错误的地址(比如
/no-such-page),也被302跳到登录页并最终拿到200 OK。在 Google 眼里,这叫全站泛滥 Soft 404(软 404)。私密分享泄露风险:用户生成的只读幻灯片分享链接(
/s/<令牌>)和团队邀请链接(/invite/<令牌>)虽然放行了免登录访问,但响应头里没有任何防收录标记,一旦链接被贴到公开论坛,私人演示稿就有被搜索引擎抓走公开的风险。
架构决策与代码实现:我们把路由守卫的默认逻辑彻底反了过来,从「默认全部跳登录」改为「明确声明谁是工作区、谁是公开页、谁是免登录但绝不收录的私密链接,其余未知路径一律交还给 Next.js 返回真 404」:
只开放 5 个核心公开页 + 博客:首页(
/)、价格页(/pricing)和三份法律协议(/terms、/privacy、/refund),加上后来上线的新博客(/blog),以及/robots.txt、/sitemap.xml与/llms.txt,对所有访客和爬虫完全敞开。只有真正的业务工作台路径才跳登录:把
/projects、/new、/settings等 9 个工作台路径明确列为受保护的工作区前缀,未登录访问这些路径才触发302 -> /login?next=...。访问任何未注册的陌生路径(如/no-such-page),直接落入 Next.js 的not-found,返回干脆的 HTTP404且带上<meta name="robots" content="noindex">。私密分享链接强制打上 HTTP 响应头封条:在
proxy.ts里,凡是命中/s/<令牌>或/invite/<令牌>的请求,统一在 HTTP 响应头注入X-Robots-Tag: noindex, nofollow。同时在根布局(src/app/layout.tsx)把全站默认 metadata 设为robots: { index: false, follow: false },只有调用了publicMetadata()的公开页面才显式覆盖为index: true, follow: true。
手术二:Next.js 多语言 SEO 改造:为什么靠 Cookie 切语言等于「自废英文收录」,以及两个隐蔽的连环坑
查出的病灶:APS 的界面支持简体中文(zh-Hans)、繁体中文(zh-Hant)和英文(en)三种语言。改造前,全站共用同一个 URL(比如首页永远是 https://apsdeck.com/),后端读取用户浏览器里的 NEXT_LOCALE Cookie 或 Accept-Language 请求头来决定渲染哪种语言。claude-seo 的 seo-hreflang 模块一眼就指出了死穴,Googlebot、Bingbot 和各家 AI 爬虫在抓取网页时是不带 Cookie 的,而且默认请求头往往固定不变! 不管你的英文文案翻译得多地道,由于没有独立的 URL,爬虫一辈子都只能抓到默认的中文页面,海外英文用户搜英文关键词时根本不可能搜到你。
架构决策与代码实现:为了不动现有的目录结构(不用把整个 src/app/ 搬进 [locale]/ 动态路由目录下重构几十个内部链接),我们采用了最轻量也完全符合 Google 规范的 查询参数独立地址方案(?lang=):
每种语言独立标准地址:每个公开页面的每种语言都有自己唯一的标准地址,即
/?lang=en、/?lang=zh-Hans与/?lang=zh-Hant。URL 参数最高优先级:URL 里的
?lang=参数优先级高于 Cookie 和浏览器默认语言。x-default兜底地址:不带参数的裸地址(如/、/pricing)按访客浏览器语言自适应显示,并在hreflang矩阵中作为x-default(默认兜底地址)。站内链接自动继承语言参数:站内所有公开页面的导航和页脚链接,统一通过
withLang(href, lang)工具函数自动继承当前 URL 的?lang=参数。这样爬虫从/?lang=en点进价格页,顺着<a href="/pricing?lang=en">抓到的依然是纯正的英文版!
来看看 src/lib/seo.ts 里生成 canonical 和双向 hreflang 的核心实现(注意里面还处理了一个真实业务细节,我们的三份法律协议只有英文原版和简体中文译本,没有单独的繁体译本,所以繁体界面访问 /terms?lang=zh-Hant 时,它的 canonical 会自动归并指向简体地址 /terms?lang=zh-Hans,避免被判重复页面):
// src/lib/seo.ts
export const langPath = (path: string, lang: Locale | null) =>
  lang ? `${path}?lang=${lang}` : path;

/** hreflang:列出该页面支持的每种语言地址,加上不带参数的 x-default */
export function alternates(page: PublicPage, lang: Locale | null): NonNullable<Metadata['alternates']> {
  // 法律页面没有繁体译文:繁体界面的地址算简体版本(canonical 指向简体的地址)
  const own = lang && page.langs.includes(lang) ? lang : lang ? 'zh-Hans' : null;
  return {
    canonical: langPath(page.path, own),
    languages: {
      ...Object.fromEntries(page.langs.map((l) => [l, langPath(page.path, l)])),
      'x-default': page.path,
    },
  };
}实战中踩到的两个隐蔽连环坑:
连环坑 A(查询参数
?lang=跟业务功能参数撞名):改完第一版跑端到端测试时,新建演示稿的测试突然挂了。一查才发现,工作台内部的/new?lang=en参数本来是用来表示「新建一份英文幻灯片」(哪怕用户自己的界面语言是中文)!如果让?lang=全局控制界面语言,用户在中文界面点「新建英文演示稿」,整个工作台界面会莫名其妙变成英文。解法是写了一个严格的纯函数isLangPage(pathname),只允许在 5 个公开页面和/login登录页上让?lang=决定界面语言,进入工作台后的/new?lang=完全保持原有的业务含义,互不干扰。连环坑 B(Next.js 的
router.replace只刷新页面正文,导致<html lang>和顶栏菜单不同步):访客在/pricing?lang=zh-Hans页面点击顶栏语言切换器切到English,我们最初调用了 Next.js 的客户端路由router.replace('/pricing?lang=en')。结果诡异的一幕发生了,页面中间的价格卡片确实变成了英文,但浏览器 DOM 顶层的<html lang="zh-Hans">属性没变,连顶栏语言切换器自己(挂载在根 Layout 下的客户端组件)还停留在中文!原因是在 Next.js App Router 中,router.replace只会重新渲染当前page.tsx这一层路由段,不会重新执行最外层根布局(Root Layout)里的NextIntlClientProvider和<html lang>。解法是在带?lang=的公开页面切换语言时,写入 Cookie 后直接执行整页跳转加载新地址,确保从<html lang>、顶栏到正文 100% 同步刷新。
手术三:品牌词「撞车」危机:从 APS 到 APS Deck 的全链路实体对齐
查出的病灶:做完第一轮技术修复后,我们跑了一次品牌可搜索性排查。在 Google 和 AI 搜索里输入 APS AI presentation,出来的第一页结果全都是一款叫 APS(Auto Presentation Switcher) 的海外老牌会议室多电脑演示切换软件;而直接搜我们的域名主体 apsdeck,由于全站 <title> 和正文里只写了简称 APS,搜索引擎根本不知道 apsdeck.com 对应一个叫 APS Deck 的品牌,结果一片空白。
架构决策与代码实现:取一个三个字母的英文缩写当名字,在 SEO 冷启动阶段是非常吃亏的。但我又不想把软件内部工作台简洁的 APS 标志全部推翻重写。于是我们做了一次「内外分层、全链路实体对齐」:
软件内部与法律条款保持原名:登录后的工作台标签页、左上角紧凑 Logo 依然叫
APS。所有对外公开页面的展示层统一升级为
APS Deck(与域名apsdeck.com严丝合缝对上):首页英文标题改为APS Deck · AI presentation editor for lecturers and creators,首页中文标题改为APS Deck · 面向讲师和创作者的 AI 演示稿编辑器,价格页与三份法律协议标题末尾统一加上· APS Deck,Open Graph 的og:site_name也统一设为APS Deck。在 JSON-LD 结构化数据里建立「别名映射矩阵(
alternateName)」:Google 搜索结果每一条记录最上方显示的那个「站点名称(Site Name)」,正是从首页WebSite和Organization结构化数据的name与alternateName字段读取的。我们在src/lib/seo.ts里把主名定为APS Deck,并把用户可能搜索的所有变体放进alternateName。在首页 FAQ 第一句话里显式完成「实体缝合」:把首页常见问题第一条的开头改成 「APS(也叫 APS Deck,网址 apsdeck.com)是一个面向讲师和创作者的 AI 演示稿编辑器……」。就是这一句话,让 Google 的 AI 在不到 24 小时后的回答里,第一句就准确写出了
APS Deck(网址:apsdeck.com)是一款面向讲师和内容创作者的 AI 演示稿编辑器!
export const BRAND = 'APS Deck';
export const BRAND_ALIASES = ['APS', 'apsdeck', 'apsdeck.com'] as const;

export function websiteLd(origin: string, locale: Locale): Ld {
  return {
    '@type': 'WebSite',
    '@id': `${origin}/#website`,
    name: BRAND,
    alternateName: [...BRAND_ALIASES],
    url: `${origin}/`,
    inLanguage: locale,
    publisher: { '@id': `${origin}/#organization` },
  };
}
手术四:首页 HTML 从 256 KB 砍到 84 KB(瘦身 67%):揪出藏在 SSR 里的两头「吞金兽」
查出的病灶:claude-seo 的 seo-performance 脚本在扫描首页时弹出了一个醒目的警告,仅仅是首页的原始 HTML 文档(不含外部 JS 和 CSS),体积就高达 256 KB!一个以文字和卡片为主的 SaaS 落地页,256 KB 的 HTML 绝对是不正常的。这不仅会拖慢首字节时间(TTFB)和最大内容绘制(LCP),ChatGPT 和 Perplexity 的爬虫来抓页面时,冗余的垃圾字符也会白白占满大模型的上下文窗口,降低正文核心事实的提取权重。
顺藤摸瓜找真凶:我们把服务端渲染吐出来的 256 KB HTML 拉出来一分析,当场抓到了两头躲在暗处的「吞金兽」:
第一头吞金兽(内联 base64 图片):3 张示例幻灯片封面图被转成了
data:image/webp;base64,...直接硬编码在 HTML<img>标签里!光这三串长长的 base64 字符就吃掉了近百 KB,而且每次刷新页面都要跟着 HTML 重新下载,浏览器根本无法单独缓存图片。第二头吞金兽(全量多语言字典序列化):
NextIntlClientProvider把全站近 10 万字的多语言字典全量塞进了客户端 Hydration 脚本!在根布局src/app/layout.tsx里,为了给客户端组件提供多语言支持,代码默认调用了getMessages()把整个应用所有模块的翻译文案(包括复杂的幻灯片编辑器、几十种版式说明以及模板库和账单管理等上千条字符串)原封不动序列化进了<script>标签里下发给浏览器。未登录访客看一个首页介绍,真正用到的客户端交互组件其实只有顶栏的「语言切换下拉框」而已!
手术方案与立竿见影的效果:
剥离 base64 图片为独立可缓存路由:新建了
src/app/examples/[template]/[file]/route.ts,把首页展示的示例封面改成标准的<img src="/examples/course-launch/borealis.zh-Hans.webp" width="1280" height="720" ...>,并加上Cache-Control: public, max-age=86400缓存头(同时对路径参数做严格的白名单正则校验防止目录穿越)。按页面类型精准裁剪下发给客户端的语言包命名空间:在
src/lib/seo.ts里定义了公开页面仅需的 6 个轻量命名空间PUBLIC_CLIENT_NAMESPACES = ['app', 'common', 'generate', 'account', 'errors', 'errorPages']。遇到公开介绍页或博客请求,就只把这几组极小的文案传给客户端 Provider。最终战果:改动前后对比,首页原始 HTML 体积从 256 KB 直接暴跌到 84 KB,足足砍掉了 67%! 首屏秒开,HTML 源码里剩下的全是高密度的产品干货。
手术五:构建 JSON-LD 实体图谱(@graph)与 Playwright 一键渲染三语分享大图(pnpm aps og)
查出的病灶:改造前的页面既没有 Open Graph / X(Twitter)社交分享卡片,也没有任何 JSON-LD 结构化数据。把网址发到 X、微信或 Slack 里,只会显示一个灰扑扑的光秃秃链接,毫无点击欲望。
架构决策与代码实现:
用
@graph构建严密的 JSON-LD 实体网络:我们在首页和价格页注入了由Organization、WebSite、SoftwareApplication和BreadcrumbList组成的复合图谱,在/blog和文章页注入了Blog与BlogPosting。特别是针对SoftwareApplication,我们把 11 月 5 日过审后正式上架的 4 档真实报价(月付订阅 $4、年付订阅 $40,外加 1 个月 $5 和 12 个月 $50 的单次时长包)全部写进了offers数组,并严格遵守 Google 2026 规范,不写FAQPage,不编造任何虚假评分。写一个 40 行的 CLI 命令
pnpm aps og,用代码自动生成三语 1200×630 分享大图:很多开发者懒得配og:image,是因为不想打开 Figma 或 Photoshop 一张张手搓不同语言的图片,而且一旦首页改了一句标语,图片又得重新导出。既然我们的仓库里本来就有 Playwright 无头浏览器和sharp图像处理库,我直接让 Claude Code 在packages/cli/src/cli.ts里加了一个pnpm aps og子命令,自动读取en、zh-Hans和zh-Hant三种语言的landing.json真实标题,用 HTML + CSS Grid 排出左侧品牌 Logo、蓝字卖点眉题、粗体大标题与apsdeck.com域名,右侧叠放两张带立体阴影的真实官方模板幻灯片预览图,启动 Chromium 在1200×630视口下等待字体就绪后截图,通过sharp无损压缩输出到apps/web/public/og/apsdeck-<locale>.png。以后不管什么时候改了品牌色或首页文案,敲一行pnpm aps og,三张语言的超清社交分享大图 3 秒钟全部自动更新到位!
// src/lib/seo.ts:序列化 JSON-LD 时把 < 转义为 \u003c,彻底杜绝动态文案中包含 </script> 引发 XSS 注入
export const ldJson = (graph: Ld[]) =>
  JSON.stringify({ '@context': 'https://schema.org', '@graph': graph }).replace(/</g, '\\u003c');
手术六:面向 AI 引用(GEO)的四板斧:事实胶囊问答、10 大 AI 爬虫放行、同源 /llms.txt 与 IndexNow 自动推送
为了让 ChatGPT、Perplexity、Claude 和 Google AI 在读到 apsdeck.com 时能毫不费力地提取出标准答案,我们在代码里落下了四记重锤:
第一板斧:在首页直接写出 6 组「首句给结论」的常见问题(FAQ)
FAQ 没藏进折叠面板(Accordion),直接在首页底部用语义化的 <section aria-label="Questions"> + <h3> 问题 + <p> 段落全部平铺直出。6 个问题精准覆盖了人类和 AI 最关心的全部事实维度:
APS 是什么? 明确定义「APS,也叫 APS Deck,网址 apsdeck.com」及四步核心工作流。
要自己准备模型吗? 明确说明 BYOK 机制:支持 OpenAI / Anthropic 协议 API Key,或直接用 ChatGPT / GitHub Copilot 订阅通过设备码登录,断开模型仍可编辑导出。
APS 多少钱? 明确列出订阅 $4/月、$40/年,单次时长包 $5/月、$50/年,新注册免绑卡送 14 天试用,大陆可用微信支付买单次包。
能导出什么? 网页全屏放映、带演讲者备注与画笔,支持生成可设密码和有效期的分享链接,还能导出 PDF / 可编辑 PPTX / PNG / 离线包。
支持哪些语言? 界面简/繁/英三语,生成内容支持任意语言。
我的数据放在哪? 在线版托管于新加坡服务器,支持一键导出完整备份 zip 与随时删号。
第二板斧:robots.txt 显式点名放行 10 大 AI 爬虫
在 src/app/robots.ts 里,除了给通用爬虫 * 配置公开白名单与私密黑名单外,专门把 10 个主流 AI 爬虫全部单列出来赋予同等公开页抓取权限,消除任何规则歧义:
// src/lib/seo.ts
export const AI_CRAWLERS = [
  'OAI-SearchBot', 'ChatGPT-User', 'GPTBot',
  'Claude-SearchBot', 'Claude-User', 'ClaudeBot',
  'PerplexityBot', 'Google-Extended', 'Applebot-Extended', 'CCBot',
] as const;
第三板斧:与首页文案和价格配置「同源生成」的 /llms.txt
如前文所述,src/app/llms.txt/route.ts 直接调用 next-intl 的 createTranslator 读取 en/landing.json 和 zh-Hans/landing.json 里的 FAQ 原文,并实时读取 PLANS 价格配置、试用天数以及 /blog 下已发布的文章列表,动态拼装成符合 llmstxt.org 和 Lighthouse 校验规范的 Markdown 响应(带 Cache-Control: public, max-age=3600)。
第四板斧:接入 IndexNow 协议,每次发版后自动向搜索引擎主动推送新地址
Google 靠 Search Console 的 Sitemap,而 Bing(以及依赖 Bing 索引的 ChatGPT Search)、Yandex 和 Naver 等搜索引擎共同支持一套主动推送协议 IndexNow。我们在 src/lib/indexnow.ts 和 src/instrumentation.ts 里实现了一套全自动机制:
自动暴露密钥校验文件:在生产环境
.env配好APS_INDEXNOW_KEY,访问https://apsdeck.com/<key>.txt会自动返回该密钥供搜索引擎核验所有权。按
BUILD_ID触发单次推送:每当 Docker 容器部署了新版本(Next.js 的.next/BUILD_ID发生变化),服务启动 60 秒稳定后,自动把所有公开页面的多语言地址、博客首页和已发布的文章地址打包成 JSON POST 给https://api.indexnow.org/indexnow,并把当前BUILD_ID记录在本地indexnow.json中(同一版本重启容器绝不重复打扰,新发版才推一次)。
手术七:用单元测试 + Playwright E2E 测试锁死 SEO 基建,拒绝「下次改代码又偷偷坏掉」
做过持续迭代项目的朋友都知道,SEO 最怕三个月后重构某个组件时,不小心把 canonical 删了、把新加的后台页面漏设了 noindex,或者谁又往首页塞了一张 500 KB 的大图,直到半年后流量掉光了才发现。
所以在改完代码的同一天,我和 Claude Code 直接在测试套件里筑起了五道自动化防线(包含 apps/web/test/seo.test.ts、test/posts.test.ts、test/indexnow.test.ts、test/online.test.ts 以及端到端测试 e2e/tests/seo.spec.ts、e2e/tests/blog.spec.ts):
// e2e/tests/seo.spec.ts:专门创建一个不带任何 Cookie、伪装成 Googlebot 的纯净请求上下文
async function crawler(): Promise<APIRequestContext> {
  return playwrightRequest.newContext({
    baseURL: BASE,
    extraHTTPHeaders: {
      'user-agent': 'Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)',
    },
  });
}
每次跑测试时,这个模拟的 Googlebot 会把全站所有公开页面 × 所有语言版本挨个抓一遍,执行严苛的断言:
状态码与语言匹配:17 个公开地址全部返回
200,<html lang>与 URL 参数严格一致。品牌词与摘要长度:
<title>必须包含APS Deck,英文description不少于 100 个字符,中文不少于 40 个汉字。Canonical 与 Hreflang 闭环:每个地址的
canonical必须指向自己(繁体法律页指向简体),hreflang必须完整包含所有支持语言 +x-default。分享卡片与 150 KB 体积红线:
og:image必须返回200 image/png。首页 HTML 源码严禁出现data:image/webp;base64,且总长度必须小于150,000字节(谁敢往首页塞大图,CI 当场红叉报错!)。结构化数据与隐私边界:JSON-LD 必须合法且不得包含
aggregateRating、review或FAQPage。未知地址必须返回真404,/login、/settings以及/s/<令牌>和/invite/<令牌>必须带有noindex。甚至有一条单元测试专门递归扫描src/app/目录下的每一个page.tsx,只要有人新建了页面却没在「公开页名单」或「登录保护名单」里登记,测试直接挂掉!
部署上生产环境后,我们又用 claude-seo 自带的本地校验脚本对着线上真实的 https://apsdeck.com 跑了一遍复测,Sitemap 17/17 页面返回 200,JSON-LD 结构化数据 17/17 满分通过校验,模拟 GPTBot、OAI-SearchBot、ClaudeBot、Claude-SearchBot 与 PerplexityBot 五大 AI 爬虫实测全部返回 200 且拿到完整 HTML 正文!
五、实战效果复盘与我自己的深度理解:为什么不到 24 小时就能被 Google AI 原样引用?
1. 提交搜索引擎的黄金 20 分钟操作流(GSC + Bing)
代码部署并复测通过后,如果你只是干等着搜索引擎自己顺着外链爬过来,一个没有任何历史权重的新域名可能要等上好几周。想让收录按「小时」计算,必须主动走完这 20 分钟的标准提交动作。
第一步:Google Search Console(约 15 分钟)
添加网域级资源:打开 Google Search Console,点击左上角「添加资源」,选择左侧的「网域(Domain)」模式,填入
apsdeck.com(不带https://和www,网域级资源能一次性覆盖 http/https 和带不带 www 的所有子域)。DNS TXT 秒级验证:复制 Google 给出的
google-site-verification=...字符串,去 Cloudflare 的 DNS 页面添加一条@的TXT记录,切回 GSC 点击验证(秒过)。提交站点地图:在左侧菜单进入「站点地图(Sitemaps)」,输入
sitemap.xml点击提交,后台立刻显示状态「成功」,已发现 17 个网址。手动请求高优索引(最关键的提速动作):在页面最顶部的「网址检查(URL Inspection)」搜索框里,手动把最核心的 5 个入口地址(首页
/及其英简双语地址、价格页英简双语地址)挨个粘进去,点击「请求编入索引(Request Indexing)」。这相当于直接把你的核心页面插队塞进 Googlebot 的高优先级抓取队列!
第二步:Bing Webmaster Tools(约 5 分钟,搞定 Bing + ChatGPT 搜索源)
同账号直接登录:打开 Bing Webmaster Tools,直接用刚才同一个 Google 账号登录。
从 GSC 一键导入:选择 「Import your sites from GSC(从 Google Search Console 一键导入)」,域名所有权验证和
sitemap.xml会自动同步过来,连 DNS 都不用再配一次。批量主动提交网址:在左侧菜单点开 「URL Submission」,把上面那 5 个核心地址一次性粘贴进去点击 Submit(加上我们已经配好的
IndexNow,以后发新文章都会自动推送给 Bing)。
2. 效果溯源:逐句拆解 Google AI 回答是怎么「抄作业」的
提交完第二天一早(不到 24 小时),我在 Google 搜 site:apsdeck.com,不仅网页索引已经全部躺在了结果列表里,最上方弹出的 Google AI 回答(AI Overview) 更是让我直观见证了什么叫「教科书级的 GEO 命中」。
我们不妨把文章开头那张截图里 Google AI 生成的每一句话,跟我们在代码仓库里埋下的信息源做一次 1 对 1 的法医级溯源对照:
| Google AI 回答生成的原文内容 | 对应我们在 apsdeck.com 埋下的精确信息源 | 为什么大模型会优先选中并原样摘录它? |
|---|---|---|
| 开篇定性定义:「APS Deck(网址:apsdeck.com)是一款面向讲师和内容创作者的 AI 演示稿编辑器。它可以帮助用户将讲稿、笔记或文章快速转化为高质量的 HTML 演示稿。」 | ① 首页 <title>:APS Deck · 面向讲师和创作者的 AI 演示稿编辑器 ② WebSite / SoftwareApplication Schema:name: "APS Deck", alternateName: ["APS", "apsdeck"] ③ 首页 FAQ 第一条首句:APS(也叫 APS Deck,网址 apsdeck.com)是一个面向讲师和创作者的 AI 演示稿编辑器…… | 标题、JSON-LD 实体名与正文第一句形成了三重语义对齐,且第一句话就是标准的「A 是面向 B 的 C 工具」定义句式,零修辞杂质,置信度拉满 |
| 核心功能特点(5 条项目符号):① AI 创作与交互(对话梳理大纲、局部自然语言修改及版本回滚) ② 模型自带机制(不销售模型额度,支持自有 API 或兼容订阅,断开模型仍可编辑放映导出) ③ 放映与分享(全屏放映、演讲者备注与画笔圈画,支持可设密码和有效期的分享链接) ④ 多格式导出(导出 PDF、可编辑 PPTX 与高清 PNG 及离线放映包) ⑤ 语言与服务(中英文界面,数据托管于新加坡服务器并支持完整备份与删号) | 完美对应首页平铺直出的 第 1、2、4、5、6 条常见问答(messages/zh-Hans/landing.json 的 faq 字段) 以及 SoftwareApplication.featureList!注意看细节:「断开模型时仍可手动编辑、放映与导出」、「可设密码和有效期的只读分享链接」、「数据托管于新加坡服务器并支持完整备份与删号」,这些极具辨识度的具体事实,全站只有首页 FAQ 里写过! | 这 5 组问答在 HTML 里全部采用 <h3>疑问句</h3> + <p>结论句</p> 的扁平结构,且服务端 SSR 直出、页面体积仅 84 KB,大模型无需跨越复杂 DOM 就能把 5 段高密度事实压缩成 5 个要点 |
底部 4 行资费方案表格:提供 14 天免绑卡免费试用 ① 月度订阅:4 美元 / 月(自动续费,随时可取消) ② 年度订阅:40 美元 / 年(自动续费,随时可取消) ③ 1个月时长包:5 美元 / 个月(一次性付费,不自动续费) ④ 12个月时长包:50 美元 / 12个月(一次性付费,不自动续费) | ① 首页 FAQ 第 3 条(faq.price.autoRenew + faq.price.trial) ② SoftwareApplication Schema 中的 offers 数组(精确包含这 4 个 Offer 对象的 name、price: "4.00" / "40.00" / "5.00" / "50.00"、priceCurrency: "USD") | 正文里的自然语言价格说明 + JSON-LD 里的结构化 Offer 机器账本互相印证,让 AI 能够以 100% 的确定性直接渲染出结构化对比表格,连一分钱都没算错 |
看到这儿,GEO 的秘密其实很透彻了。大模型全靠搬运高密度事实,谁把事实喂得最干净、结构最清晰、交叉验证最一致,它就把谁的文字当成标准答案!
3. 我对 AI 时代 SEO 与 GEO 的四点个人理解(独立开发者视角)
SEO 的权力正在发生交接:从「营销运营人员的手工填表」彻底变成「全栈工程与 CI 里的一等公民」。以前在传统公司里,SEO 往往被当成产品上线后甩给运营或外包团队的脏活累活,无非是去后台 CMS 手工填一下 meta description,或者买点软文外链。到了 Next.js + AI 编程的时代,最高效、最彻底的 SEO 其实是纯正的软件工程问题。谁最清楚哪些路由是公开页、哪些是私密页?程序员。谁能把首页 HTML 从 256 KB 砍到 84 KB?程序员。谁能让网页正文的价格、JSON-LD 里的
Offer以及/llms.txt里的数字全部绑定到同一个 TypeScript 常量上,改一处全站自动同步、永远不会出现前后矛盾?还是程序员!把 SEO 当成代码架构的一部分,再用 Playwright 自动化测试锁进 CI 流水线里,是我们技术人做增长最大的降维打击。GEO 的核心心法只有六个字:「说人话,给结论」,彻底戒掉自嗨的营销黑话。很多技术人员写产品官网时,总觉得写大白话不够「高大上」,喜欢模仿大厂公关稿写一堆「重构次世代智能工作流、赋能全场景生产力跃迁」。在传统搜索时代,这种废话顶多是降低人类访客的转化率。到了 AI 搜索(GEO)时代,写废话等于直接放弃被 AI 引用的资格。大模型做 RAG 检索汇总时,是在有限的 Token 预算里寻找高信息熵的「事实三元组(实体 - 属性 - 确定值)」。放下架子,用最朴实无华的句子在页面上写清楚「我叫什么、网址多少、解决哪类人的什么问题」,再把「分哪几步用、具体收几美金、支不支持退款、数据存在哪个国家」列明白,不仅人类用户看着倍感真诚,AI 引擎更是会像捡到宝一样把你整段摘录。
claude-seo代表了 AI Agent 插件的最佳工程范式:「代码测事实 + 规则做约束 + 模型做决策」。这次用claude-seo,让我对怎么设计好用的 Claude Code Skill / Agent 有了全新的认识。为什么它比网上那些只有一段 Prompt 的所谓「SEO 提示词」强出十条街?它守住了一条工程铁律,凡是能用确定性代码(Python 脚本 + 无头浏览器)测出来的客观事实,绝不让大模型去猜。凡是随时间变化的行业规则(比如 2026 年 5 月废弃FAQPage),全部写成结构化的参考文档按需挂载。最后才让大模型发挥它的长处,综合诊断并直接动手改你的业务代码。清醒认识「85 分」与「100 分」的分界线:技术基建决定下限,真实内容与品牌提及决定上限。虽然不到一天就被 Google 收录且被 AI 完美引用让我很兴奋,但我心里非常清醒。靠
claude-seo在一天之内把代码改到满分,解决的是「从 0 分到 85 分」的下限问题。有人搜你的品牌词(APS Deck、apsdeck)或者 AI 爬虫过来抓取时,能保证百分之百抓得到、读得懂且引用不出错。但如果你想拿到剩下的 15 分,比如让一个根本不知道你名字的海外老师,在搜泛词best AI presentation maker for lecturers时也能在第一页看到你,光靠改代码是做不到的。那剩下的 15 分,必须靠持续输出真正有深度的实战内容(这也是为什么我紧接着就在apsdeck.com/blog上搭建了自带BlogPostingSchema 和IndexNow推送的原生博客,把这两篇万字长文直接发在自己主站上!),再去 X、Reddit、Hacker News 与 Product Hunt 等社区真诚分享,攒下真实的品牌提及(Brand Mentions)与口碑外链。
六、国内开发者必踩的 6 个实战大坑(附完整破局代码)
如果你人在国内,电脑上开着科学上网工具(Clash、Surge 或 Sing-box 等)去跑 claude-seo 和提交搜索引擎,几乎 100% 会撞上下面这几个让人抓狂的怪坑。这里我把根因和一行命令就能解决的方案全部贴出来:
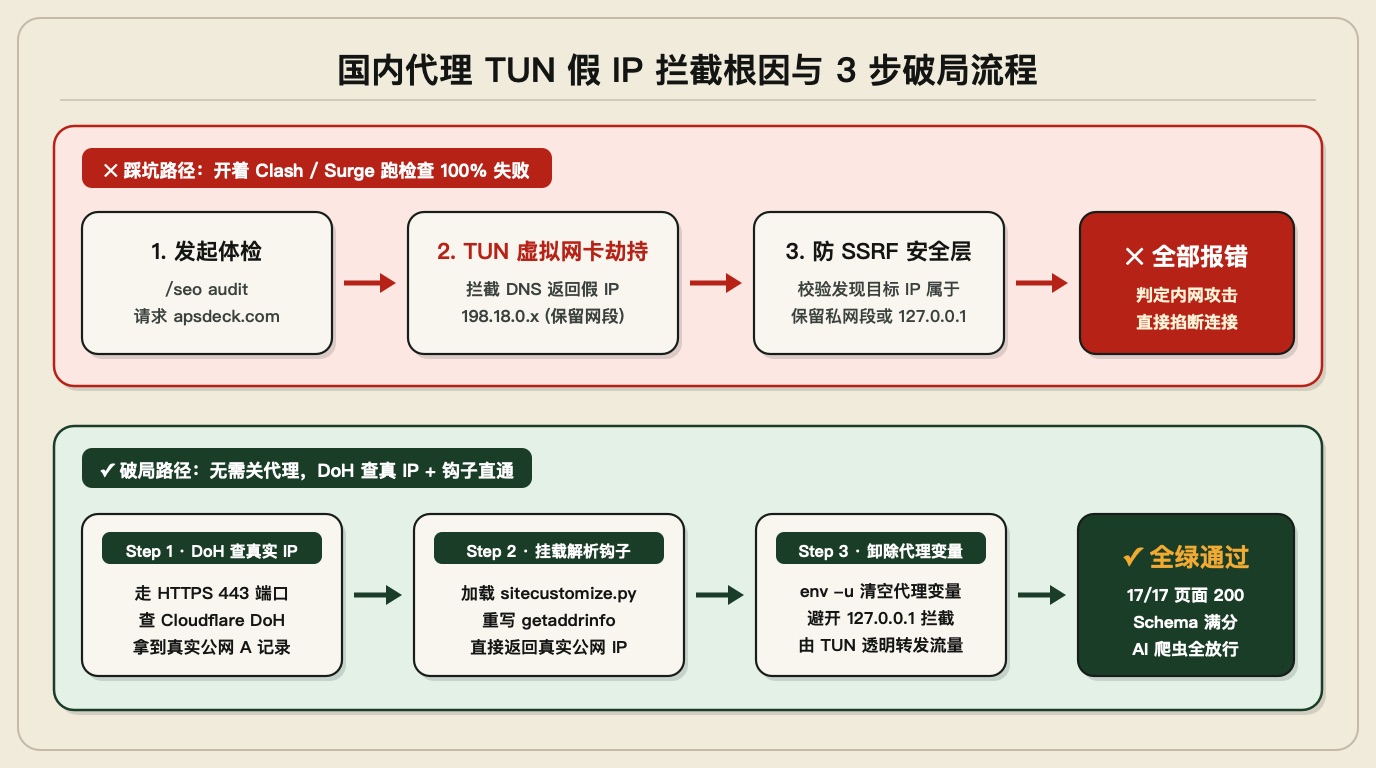
1. 大坑一:开着代理跑 claude-seo,检查结果为什么 100% 全部失败?
诡异现象:网站明明在浏览器里秒开,curl https://apsdeck.com 也是正常的 200 OK。但只要在 Claude Code 里一跑 /seo audit https://apsdeck.com 或调用插件的 Python 检查脚本,所有抓取任务瞬间全部报错失败,提示目标地址属于被禁止的私有/保留网络(SSRF blocked)!
底层根因:这是国内代理软件的 TUN / Fake-IP 机制与 claude-seo 的防 SSRF 安全层正面相撞的结果:
TUN 模式返回假 IP:本地开启 Clash、Surge 或 Sing-box 的 TUN 虚拟网卡模式(增强模式) 后,代理软件为了极速分流,会拦截系统的 DNS 查询,直接返回一个
198.18.0.x网段的假 IP(Fake-IP,属于 IANA 划分的 RFC 2544 网络基准测试保留地址段198.18.0.0/15)。防 SSRF 安全层拦截保留网段:
claude-seo底层的 Python 抓取脚本为了防止被恶意网页诱导去扫描内网(SSRF 攻击),在发起 HTTP 请求前会先调用socket.getaddrinfo()解析域名,并严格检查解析出来的 IP 是否落在私有或保留网段里。它一看apsdeck.com解析出来居然是198.18.x.x,当场判定为内网攻击直接掐断连接!本地回环代理同样被拦:如果你试图通过设置环境变量
HTTP_PROXY=http://127.0.0.1:7890走普通代理端口,它的安全层同样会因为检测到回环地址127.0.0.1而直接拒连!
完美破局方案(DoH 查真 IP + sitecustomize.py 注入解析钩子):不需要关掉你的科学上网工具(关掉反而连不上 Claude 和海外站了)!既然 TUN 模式在底层是按真实目标 IP 透明转发 TCP 流量的,我们只需要绕过本地被污染的 DNS,用走普通 HTTPS 的 DNS-over-HTTPS(DoH)查出域名的真实 Cloudflare 节点 IP,然后在运行插件的 Python 环境里挂一个 tiny 钩子,把域名的解析结果直接替换成真实 IP,同时清空 HTTP_PROXY 环境变量即可:
# 第一步:用 Cloudflare 的 DNS-over-HTTPS 接口查出你域名的真实公网 A 记录 IP(走 443 端口 HTTPS,不会被代理拦截)
curl -s -H 'accept: application/dns-json' 'https://cloudflare-dns.com/dns-query?name=apsdeck.com&type=A'
拿到返回的真实 IP(比如 172.67.x.x,104.21.x.x)后,在 /tmp/seo_hook 目录下放一个 8 行的 sitecustomize.py(Python 启动时会自动加载 PYTHONPATH 下的 sitecustomize.py):
# /tmp/seo_hook/sitecustomize.py
import os, socket

ips = [ip.strip() for ip in os.environ.get('REAL_IPS', '').split(',') if ip.strip()]
_orig_getaddrinfo = socket.getaddrinfo

def _patched_getaddrinfo(host, port, *args, **kwargs):
    if ips and host in ('apsdeck.com', 'www.apsdeck.com'):
        return [(socket.AF_INET, socket.SOCK_STREAM, 6, '', (ip, port or 443)) for ip in ips]
    return _orig_getaddrinfo(host, port, *args, **kwargs)

socket.getaddrinfo = _patched_getaddrinfo
接着在运行 claude-seo 的脚本时,把 PYTHONPATH=/tmp/seo_hook 和 REAL_IPS 传进去,并用 env -u 卸掉代理环境变量(底层 TCP 依然会丝滑地走你的 TUN 虚拟网卡出境):
env -u HTTP_PROXY -u HTTPS_PROXY -u ALL_PROXY -u http_proxy -u https_proxy -u all_proxy \
  REAL_IPS="172.67.x.x,104.21.x.x" PYTHONPATH="/tmp/seo_hook" \
  ~/.claude/plugins/claude-seo/.venv/bin/python <脚本路径> https://apsdeck.com
加上这几行代码后,原本满屏红叉的 claude-seo 脚本瞬间全绿通过!
2. 大坑二:dig @1.1.1.1 TXT apsdeck.com 一直超时,没法验证 DNS 记录
原因:验证 Google Search Console 的
google-site-verificationTXT 记录时,教程常让你在终端敲dig @1.1.1.1 TXT 你的域名。但在国内开着代理时,发往外部1.1.1.1:53的原生 UDP DNS 数据包往往会被本地代理或运营商防火墙直接丢弃,导致一直connection timed out。解法:同样改用上面那个走标准 HTTPS 的 DNS-over-HTTPS(DoH) 命令,把末尾的
type=A换成type=TXT,1 秒钟就能看到全球已生效的 TXT 记录。
curl -s -H 'accept: application/dns-json' 'https://cloudflare-dns.com/dns-query?name=apsdeck.com&type=TXT'3. 大坑三:跑性能检查时 PageSpeed Insights 报 429 Rate Limit Exceeded
原因:
claude-seo在不配置 Google API Key 的情况下调用 PageSpeed Insights 接口时,使用的是全球未认证用户的公共免费配额池,高峰期经常被大家用光而报配额超限。解法:两个办法任选其一,要么直接用自己的浏览器打开 pagespeed.web.dev 输入网址测(浏览器端有独立配额),要么去 Google Cloud Console 免费申请一个启用
PageSpeed Insights API的 Key 配给插件,每天有充裕的专属免费额度。
4. 大坑四:Cloudflare 新域名的两个「隐形杀手」开关
原因:前文提到过,很多人在代码里把
robots.txt配得完美无缺,结果用OAI-SearchBot或PerplexityBot去抓还是被拦。一查才发现是 Cloudflare 后台开了Block AI bots(AI 爬虫拦截)或者开了Managed robots.txt(Cloudflare 自动篡改你的robots.txt插入拦截规则)。解法:新站上线后第一件事,去 Cloudflare 后台检查
Security -> Bots / Settings(以及AI Crawl Control),确保不拦截 AI 搜索爬虫,并关掉Managed robots.txt,把控制权 100% 留给自己仓库里的src/app/robots.ts。
5. 大坑五:Bing Webmaster Tools 显示 Not discovered 与 URL Inspection 的列表误区
原因:刚把新域名导入 Bing Webmaster Tools 后,用它的
URL Inspection查首页,状态会显示黄色的URL is unknown to Bing / Not discovered。很多新手以为是自己网站配错了。另外,有人在URL Inspection里查了几个网址,看到页面下方列表里出现了这几个网址,就以为已经提交收录了。真相与解法:新域名在 Bing 显示
Not discovered是完全正常的初始状态,而且URL Inspection下方那个列表仅仅是你刚才「查看过的历史记录」,不代表已经提交抓取!一定要点进右上角的Request indexing按钮,或者直接去左侧菜单的URL Submission页面批量粘贴网址点Submit,这才是真正把网址送进 Bing 的抓取队列。
6. 大坑六:品牌词用简短缩写导致在搜索引擎里「查无此人」
原因:像
APS这种三个字母的缩写,在全网早就有几百个同名的协会、硬件和开源库。如果网页标题只写APS,在域名权重为 0 的冷启动期,你根本不可能排过那些存在了十年的老网站。解法:公开页面的标题、
og:site_name和 JSON-LD 的WebSite.name务必使用与域名一致的独特组合词(如APS Deck对齐apsdeck.com),再通过alternateName: ['APS', 'apsdeck', 'apsdeck.com']和正文首句定义把简称与全称绑在一起。用户无论搜APS Deck还是apsdeck,都能第一时间精准命中你。
七、横向对比:claude-seo vs 传统 SEO SaaS(Ahrefs / Semrush),独立开发者怎么选?
很多朋友会纠结,有了开源的 claude-seo,是不是就彻底不需要 Ahrefs、Semrush 这类老牌商业工具了?
我做了一张客观的对比表,帮大家看清它们各自的边界:
| 对比维度 | 开源 claude-seo(配合 Claude Code) | 传统 SEO SaaS(Ahrefs / Semrush / Moz) |
|---|---|---|
| 软件费用 | MIT 开源免费(仅消耗你原本就有的 Claude Code 订阅或 API 额度) | 昂贵:起步套餐通常 $100–$130 / 月(年付也要近千美金) |
| 数据隐私 | 100% 留在自己电脑本地,不上传任何未公开的业务数据 | 托管在第三方云端平台 |
| 核心工作流闭环 | 查完直接改代码 + 生成分享图 + 写自动化测试,一步到位 | 只出报表不干活:给你一堆红黄报错列表,怎么改 Next.js 代码还得自己去查文档 |
| AI 搜索(GEO)支持 | 原生内置且紧跟一线:自带五维评分与 AI 爬虫模拟测试,同步 Google 2026 最新规则(如废弃 FAQPage) | 各家进度不一,多数仍以传统蓝色链接排名监控为主 |
| 全网关键词库与竞品外链库 | 无自带数据库(需按需挂载 DataForSEO、Ahrefs MCP 等付费 API 扩展) | 核心壁垒:拥有全网百亿级历史外链数据库、关键词月搜索量与竞争难度(KD)估算 |
| 持续防回退能力 | 有 PostToolUse 实时校验钩子 + /seo drift 快照对比 + 直接生成仓库 CI 测试 | 依赖云端定期巡检邮件报警,无法在代码提交前(Pre-commit / CI)拦截错误 |
我的选型建议很实在,分两个阶段看:
处于冷启动期(0 → 1)的独立开发者或小团队:毫不犹豫先上免费的
claude-seo! 在产品刚上线的前三个月,你最紧迫的任务是把站内的技术 SEO、多语言hreflang和 JSON-LD 结构化数据,连同首屏性能与 GEO 事实胶囊一起做到 85 分以上。这些「改代码就能解决」的事,claude-seo的效率比传统 SaaS 高出一个数量级,还能直接帮你省下几百美金。什么时候才需要付费数据库? 等你的产品已经跑通了付费转化、准备大规模铺设几十篇英文长尾词内容矩阵(Content Marketing)或专门去拆解竞品外链来源时,再花几十美金按量充值一个 DataForSEO API 接进
claude-seo里,或者短期订一个月 Ahrefs 导出词表,性价比最高。
常见问题(FAQ)
claude-seo 是什么?完全免费吗?
claude-seo 是开发者 AgriciDaniel 开源的 Claude Code 专用 SEO 与 GEO(生成式引擎优化)插件,采用 MIT 开源协议,插件本身 100% 免费,运行时仅消耗你自己的 Claude Code 额度。v2.5.0 版本内置了 26 个子技能、19 个子智能体与 30 条 /seo 斜杠命令,并配有一套确定性 Python 检查脚本,覆盖技术 SEO、Core Web Vitals 性能、E-E-A-T 内容质量,以及 JSON-LD 结构化数据、多语言 hreflang 和 AI 搜索优化。
怎么安装和初始化 claude-seo?
在 Claude Code 终端里依次运行 /plugin marketplace add AgriciDaniel/claude-seo 和 /plugin install claude-seo@agricidaniel-claude-seo 即可完成安装。首次使用前运行 /seo setup,它会自动创建一个隔离的 Python 虚拟环境并安装无头 Chromium 浏览器。平时可运行 /seo doctor 检查环境状态,上线后用 /seo audit <你的网址> 启动全站并行体检。
GEO(生成式引擎优化)和传统 SEO 有什么本质区别?
传统 SEO 的目标是让搜索引擎爬虫顺利抓取、编入索引并在搜索结果列表里排在前面。GEO 的目标是让 ChatGPT Search、Perplexity、Claude 和 Google AI 概览在生成聚合回答时,能够顺利读到你的网页、准确提取出高置信度事实,并直接点名引用你的品牌和链接。Google 官方明确表示「为生成式 AI 搜索做优化本质上仍然是 SEO」。在做好 Google 和 Bing 技术收录的基础上,GEO 额外看重四点,即放行 AI 搜索爬虫、坚持服务端渲染(SSR),并用「首句给结论 + 具体数字」的事实胶囊写法在页面上直出常见问答,同时在外部社区积累真实品牌提及(Brand Mentions)。
2026 年做网站还要不要加 FAQPage 结构化数据?
不需要,也不要再加了。 根据 claude-seo 同步的 Google Search Central 官方说明,Google 早在 2023 年 8 月就将 FAQ 富媒体搜索结果限制在政府和医疗网站,并自 2026 年 5 月 7 日起对全网所有网站彻底停用了 FAQPage 富媒体结果展示。现在加 FAQPage JSON-LD 在搜索结果里没有任何加成。正确的做法是把常见问答用清晰的 HTML <h3> 问题 + <p> 结论直接写在页面正文里,这对人类阅读和 AI 搜索摘录反而极其有效。
/llms.txt 对 Google 搜索和 AI 引用有用吗?
对 Google 搜索没有作用,Google 官方人员已明确表态搜索系统不使用 llms.txt,claude-seo 的 GEO 评分也不给它算权重分。因为实现成本极低,建议像 apsdeck.com 一样写一个动态路由,直接从首页现有的 FAQ 多语言文案和后端价格配置常量自动生成 /llms.txt,既能给其他支持该规范的第三方 AI 工具当说明书,又永远不会产生维护负担或数据不一致。
为什么我在国内开着代理跑 claude-seo 会全部报错失败?
因为国内代理软件(Clash / Surge / Sing-box 等)的 TUN 模式会把域名解析劫持为 198.18.0.x 的 Fake-IP(属于 RFC 2544 保留地址段),而 claude-seo 内置的防 SSRF 安全网络层会将 198.18.x.x 和 127.0.0.1 判定为内网攻击地址直接拒绝连接。解决办法是用走 HTTPS 的 DNS-over-HTTPS(DoH)查出真实 IP,通过 Python 的 sitecustomize.py 挂载 socket.getaddrinfo 替换解析结果,并在运行脚本时用 env -u 清除 HTTP_PROXY 等环境变量(详见本文第六部分)。
怎么让 ChatGPT 搜索(ChatGPT Search)也能搜到并引用我的新网站?
得同时做对四件事。第一,在 robots.txt 和 Cloudflare 防火墙里明确放行 OpenAI 的搜索爬虫 OAI-SearchBot 和用户触发代理 ChatGPT-User。第二,把网站和 sitemap.xml 提交给 Bing Webmaster Tools 并接入 IndexNow 主动推送(因为 ChatGPT 搜索底层大量依赖微软 Bing 的索引库)。第三,确保页面是服务端渲染(SSR)直出 HTML。第四,在首页写清楚包含品牌全称、网址、核心功能和具体价格的常见问答。
新网站上线后多久能被 Google 收录并被 AI 引用?
如果你做好了服务端渲染、消除了软 404,配齐了 sitemap.xml 与 JSON-LD 结构化数据,并在上线当天通过 Google Search Console 验证网域资源、提交站点地图,再对核心的 3–5 个入口页面手动点击「请求编入索引(Request Indexing)」,速度可以非常快。apsdeck.com 从提交到被 Google 收录、且被 Google AI 回答直接引用完整介绍与价格表,全程不到 24 小时。如果不主动提交而只靠爬虫自然发现,新域名通常需要几天到几周时间。
写在最后:欢迎来体验 APS Deck(附上线首年 5 折优惠码)
折腾完这一趟,好的开源工具加上 AI 编程助手,正在把以前需要一个专业团队折腾半个月的增长基建,压缩成一个下午就能在代码仓库里闭环的工程日常。
如果你也在用 Claude Code 开发自己的出海产品,强烈推荐把 AgriciDaniel/claude-seo 装进你的工具箱里,顺手去 GitHub 给作者点个 Star。如果你在实操中遇到了国内代理假 IP、Next.js 多语言 hreflang 或者结构化数据的坑,希望这篇万字拆解能成为你随时翻阅的避坑手册。
最后,再认真向大家介绍一下我打磨了很久的这款产品 APS Deck(https://apsdeck.com)。
市面上很多玩具型 AI PPT 塞一句话进去就套死板模板吐出十几页废话,想改都没法改。APS Deck 走的是另一条路,专门给讲师、技术分享者和内容创作者做 AI 演示稿编辑器:
先提问理清思路,再列大纲:把你的粗糙讲稿、课程笔记或技术文章丢进去,AI 会先向你追问几个关于听众、场合与核心目标的问题,帮你搭好逻辑骨架。
逐页生成高颜值 HTML 幻灯片:确认大纲后,AI 一页页生成排版考究的 HTML 演示稿,自带 14 套官方模板与多种经典设计风格,并在服务端用无头浏览器自动做版式防溢出质检。
对话式局部精修 + 手动自由微调:哪一页不满意,直接框选那一页让 AI 用自然语言重排或改词,也可以随时手动编辑文字和调整布局,并支持随时回滚历史版本。
全链路放映与多格式导出:支持网页端全屏放映(带演讲者备注视图与激光画笔圈画)和一键生成可设密码及有效期的只读分享链接,还能高清导出为 PDF、可编辑的 PPTX,以及 PNG 图片包与离线放映包。
自带模型(BYOK),绝不赚 Token 差价:支持直接填入你自己的 OpenAI 或 Anthropic 协议 API Key(官方、中转站与 DeepSeek 等兼容接口全支持),甚至可以直接用你手头已有的 ChatGPT Plus/Pro 订阅或 GitHub Copilot 订阅通过设备码扫码登录!断开模型时,依然可以免费手动编辑、放映和导出。
🎁 读者专属福利:
新注册账号无需绑卡,直接免费赠送 14 天全功能会员体验!
上线早鸟优惠:年付订阅首年 5 折,仅需 $20 / 年(原价 $40/年,折合每月不到 $1.7)。登录 apsdeck.com 进入设置页订阅年付方案时,在收银台输入优惠码
3GXZS7NE即可立减,2026 年 11 月 30 日前有效,全网限量前 500 份。扣掉跨境通道手续费后每个月只剩一块五美金左右,纯粹是交个朋友的成本价,期待大家先用起来、多给我提反馈意见!(注:自动续费订阅支持 Visa / Mastercard / Apple Pay / Google Pay;国内习惯用微信支付的朋友,可以直接在设置页购买不自动续费的「一次性时长包」。)
👉 立即免费体验:https://apsdeck.com