用开源 claude-seo 给新网站做 SEO 和 GEO:基础知识、拆解与实战
作者:刘老板(@leo_xiaolei)· 2026 年 11 月 6 日 · 上一篇:3 天,我和 Claude 一起上线了第一个出海产品
上一篇上线全记录里,SEO 那一节被问得最多。这篇专门讲清楚三件事:SEO 和 GEO 的基础知识、开源插件 claude-seo 是怎么工作的,以及我用它给 apsdeck.com 做了什么、效果怎样。
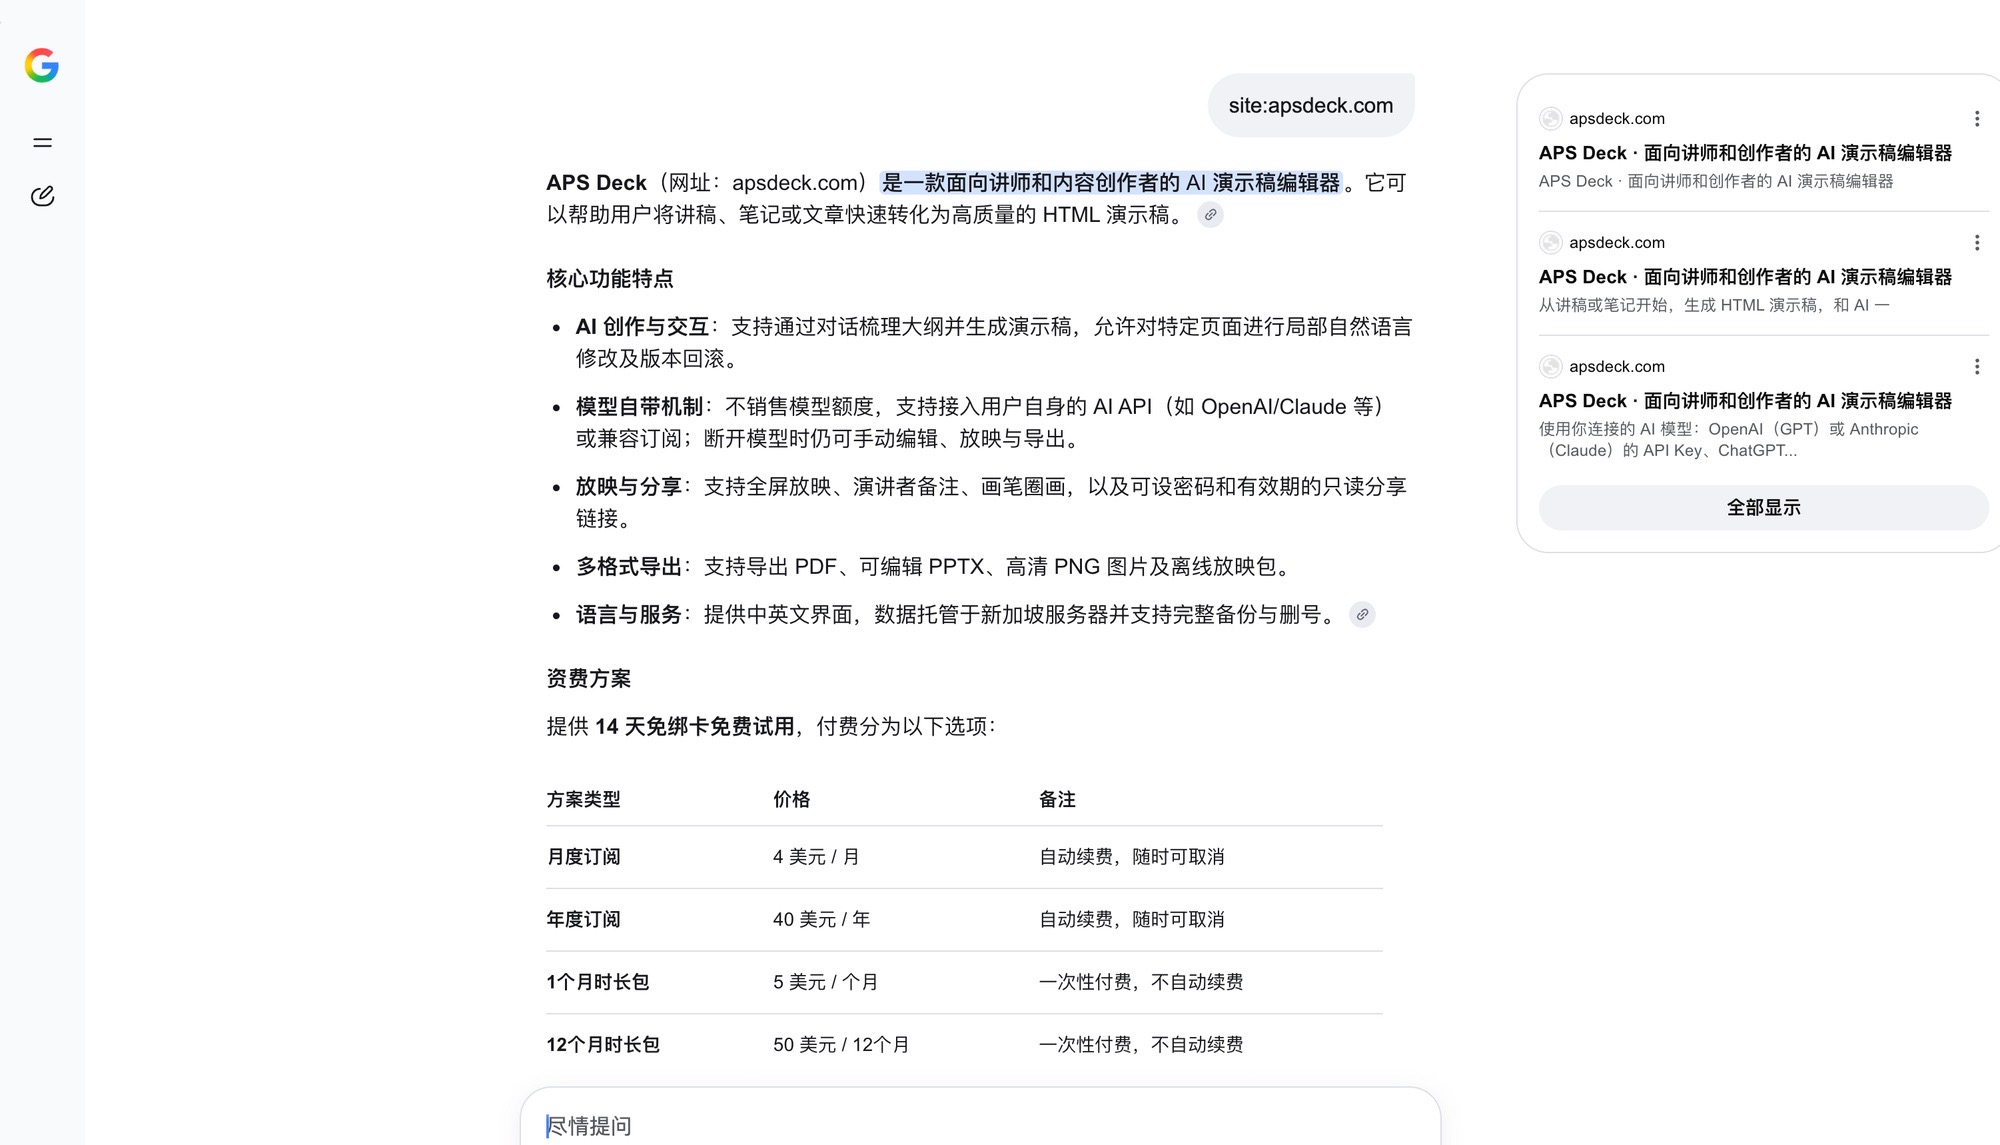
先看结果:上面这张图,是网站提交 Google Search Console 不到一天后,在 Google 搜 site:apsdeck.com 的样子。网站已经被收录,Google 的 AI 回答直接把产品介绍、功能和价格表列了出来,几乎就是网站首页常见问题的原话。
一分钟看完
SEO 是让搜索引擎能抓取、能读懂、愿意把你排在前面;GEO(Generative Engine Optimization,生成式引擎优化)是让 AI 搜索(Google 的 AI 概览和 AI 模式、ChatGPT、Perplexity、Claude)能读到、读得懂、愿意引用你。Google 自己的说法是:为生成式 AI 搜索做优化,本质上仍然是 SEO。
claude-seo 是给 Claude Code 用的免费开源插件(MIT 协议):26 个子技能、19 个子智能体、30 条命令,官方说一次全站体检 10–15 分钟,最多 17 个智能体同时跑,报告和数据都留在自己电脑上。
它最大的好处是查完就能改:插件跑在代码仓库里,Claude Code 照着检查结果直接改代码、写测试。
在 apsdeck.com 上它查出了 7 类问题:没有搜索标签、robots.txt 和 sitemap 被登录页挡住、三种语言共用一个地址、软 404、首页 256 KB、私密链接没标不收录、品牌名撞车。全部改完,并写了自动化测试。
效果:提交 Google 不到一天就被收录,AI 回答直接引用;Bing 还在排队。
国内开发者的坑:开着代理跑 claude-seo,会因为假 IP 全部失败;PageSpeed 的免费配额会被用光;
dig查不了 DNS。都有解法,见第六部分。
一、先把基础打牢:SEO 是什么
1. 搜索引擎的三步:抓取、编入索引、排名
| 步骤 | 搜索引擎在做什么 | 常见的坑 |
|---|---|---|
| 抓取(crawl) | 爬虫顺着链接和 sitemap 找到页面,先读 robots.txt 看允不允许抓 | robots.txt 写错;页面要登录才能看;被 CDN 防火墙拦掉;sitemap 打不开 |
| 编入索引(index) | 读页面内容,判断这页讲什么、是不是重复页、该用哪个地址 | 不存在的页面返回 200(软 404);同一内容多个地址却没有 canonical;内容要执行 JavaScript 才出来;误加了 noindex |
| 排名(rank) | 按和搜索词的相关性、内容质量、可信度、页面体验排序 | 标题和描述没说清楚;内容单薄;没有作者和日期;页面慢 |
前两步做不好,第三步无从谈起。所谓技术 SEO,管的主要就是前两步。
2. 技术 SEO 的基本清单
robots.txt:告诉爬虫哪些地址能抓、哪些不能,最后一行写上 sitemap 的地址。
sitemap.xml:列出你想被收录的页面和更新时间。多语言网站还可以在里面写每种语言版本的对应关系。
HTTP 状态码:不存在的页面要返回真正的 404。把所有未知地址都跳到登录页或首页,搜索引擎会当成「软 404」,浪费抓取额度。
canonical:同一份内容有多个地址时(带参数、带不带 www),告诉搜索引擎以哪个为准。
hreflang:同一页面的不同语言版本互相标注,再加一个
x-default(没有匹配语言时用哪个)。服务端渲染:正文直接写在 HTML 里,不依赖浏览器执行 JavaScript 才出来。
速度:Google 的 Core Web Vitals 看三个指标:LCP(最大内容出现的时间)、INP(点击后多久有反应)、CLS(页面会不会跳来跳去)。
不该收录的页面:登录页、后台、私密分享链接,用页面里的
<meta name="robots" content="noindex">或响应头X-Robots-Tag: noindex挡掉。
3. 页面上的 SEO
title 和 description:一句话说清是什么、给谁用,带上品牌名。搜索结果里显示的就是它们。
标题层级:一个 H1,H2、H3 层级清楚;小标题尽量写成用户会问的问题。
图片写 alt,站内页面互相链接。
分享卡片:Open Graph 和 X 卡片,配一张 1200×630 的图,链接发到社交平台时才会展开成大图。
4. 结构化数据(JSON-LD)
用 schema.org 的词汇,把「这是一个什么软件、谁做的、多少钱」写成机器能读的 JSON,放在页面的 <script type="application/ld+json"> 里。常用的类型有 Organization(运营者)、WebSite(网站)、WebPage(页面)、SoftwareApplication(软件,带 Offer 价格)、BreadcrumbList(面包屑)、BlogPosting(文章)。
两条原则:
只写页面上真有、能证明的东西:不编评分、评价和用户数。
FAQPage 不用再加了:按 claude-seo 引用的 Google 说明,2026 年 5 月 7 日起,所有网站的 FAQ 富媒体结果都不再展示,加了在搜索结果上也没有好处。问答直接写在页面正文里就行(这对 GEO 反而很有用,下面会讲)。
二、GEO:让 AI 搜索引用你
1. GEO 和 SEO 是什么关系
Google 在 Search Central 的官方说法是:从 Google 搜索的角度看,为生成式 AI 搜索做优化,就是为搜索体验做优化,因此仍然是 SEO。 claude-seo 的 GEO 检查也按这个思路来:遇到社区流行说法和 Google 的一手说法冲突时,以 Google 为准。
AI 搜索的内容从哪来:Google 的 AI 概览和 AI 模式用的是 Google 自己的索引;ChatGPT 搜索靠 OpenAI 的 OAI-SearchBot 抓取,也有一部分用到 Bing 的索引;Perplexity 和 Claude 各有自己的搜索爬虫。所以先做好 SEO,把 Google 和 Bing 都提交了,GEO 就成功了一大半。
2. AI 爬虫分两类,别一刀切
| 爬虫 | 公司 | 用途 |
|---|---|---|
| OAI-SearchBot | OpenAI | ChatGPT 搜索的来源,决定你能不能被 ChatGPT 搜索引用 |
| ChatGPT-User | OpenAI | 用户在 ChatGPT 里让它打开某个网页时 |
| GPTBot | OpenAI | 只用于训练模型,不影响 ChatGPT 搜索 |
| Claude-SearchBot、Claude-User、ClaudeBot | Anthropic | 搜索、用户让 Claude 打开网页、训练 |
| PerplexityBot | Perplexity | Perplexity 的搜索索引 |
| Google-Extended | 不是一个爬虫,而是一个开关:决定内容能不能用于 Gemini 的训练,不影响 Google 搜索和 AI 概览 |
想被 AI 搜索引用,至少要放行搜索类的爬虫;训练类的放不放看你自己(我的公开页面都是产品介绍和政策,两类都放行了)。还有两点:
Cloudflare 有「拦截 AI 爬虫」的开关,开着的话 robots.txt 写什么都没用,上线后一定去后台看一眼。
很多 AI 爬虫只读原始 HTML、不执行 JavaScript(claude-seo 举的例子是 GPTBot 和 PerplexityBot),所以服务端渲染是 GEO 的前提。
3. 什么样的内容容易被引用
claude-seo 的 GEO 评分分五个维度,正好是一份写作清单:
| 维度 | 占比 | 怎么做 |
|---|---|---|
| 可引用性 | 25% | 每一节开头 40–60 字内先给结论;写具体数字、日期和出处;用「X 是……」这样的定义句;段落能单独拿出来读 |
| 结构可读性 | 20% | 清楚的 H1、H2、H3;问题式小标题;短段落;对比用表格、步骤用列表;页面上有常见问题 |
| 多模态 | 15% | 配图、图表、视频,并写清楚说明文字 |
| 权威与品牌 | 20% | 写明作者和更新日期;引用一手资料;品牌在 Reddit、YouTube、维基百科等地方被提到 |
| 技术可访问性 | 20% | 服务端渲染;robots.txt 放行 AI 爬虫 |
其中「品牌被提到」值得单独说:claude-seo 引用的 Ahrefs 研究(7.5 万个品牌)认为,品牌被提及和 AI 可见度的相关性,是外链的 3 倍。新产品上线后,多去相关社区真诚地介绍一下自己,比买外链有用。
4. llms.txt 要不要做
llms.txt 是放在网站根目录的一页 Markdown 说明(llmstxt.org 的社区规范),设想是让大模型不用解析复杂网页就能读懂你的网站。
现状是:Google 的人明确说过搜索不使用它;claude-seo 的报告里只列出「有没有」,不给它算分。我还是做了,因为成本很低,而且内容是从首页常见问题和价格配置自动生成的,不会和页面说法对不上。但别指望它带来引用,真正起作用的还是上面那张表。
三、claude-seo 是什么,怎么装
claude-seo 是 AgriciDaniel 开发的 Claude Code 插件,MIT 协议,免费。我用的 v2.5.0:
26 个子技能(22 个核心技能 + 1 个总调度 + 1 个框架 + 2 个扩展),19 个子智能体,30 条命令分 6 组;
覆盖技术 SEO、Core Web Vitals、内容质量(E-E-A-T)、结构化数据、AI 搜索(GEO)、本地商家、电商、多语言;
官方说一次全站体检 10–15 分钟,最多 17 个智能体同时跑;报告是 Markdown,也能导出 PDF 和 JSON,数据留在自己电脑上。
在 Claude Code 里两条命令装好(装在用户级,所有项目都能用):
/plugin marketplace add AgriciDaniel/claude-seo
/plugin install claude-seo@agricidaniel-claude-seo
第一次用先跑 /seo setup:它会建一个独立的 Python 环境,并装好检查页面用的 Chromium,不污染你的系统;/seo doctor 可以随时检查环境是否就绪,不改任何东西。
最常用的命令:
| 命令 | 做什么 |
|---|---|
/seo audit <网址> | 全站体检:并行派出多个专家,汇总成健康分和行动清单 |
/seo page <网址> | 单页深度检查 |
/seo technical <网址> | 技术 SEO:抓取、索引、跳转、速度等 9 类 |
/seo schema <网址> | 检测、校验、生成结构化数据 |
/seo hreflang <网址> | 多语言的 hreflang 检查和生成 |
/seo geo <网址> | AI 搜索(GEO)检查 |
/seo agentic <网址> | AI 智能体能不能顺利访问:AI 爬虫、llms.txt、Markdown 版本 |
/seo sitemap <网址> | 分析或生成 sitemap |
/seo content <网址> | 内容质量(E-E-A-T) |
/seo google | 接 Google Search Console、PageSpeed、CrUX 等接口(需要 Google API 凭据) |
/seo drift | 给网站拍快照,之后对比变化,发现改坏的地方 |
四、拆解 claude-seo:它是怎么干活的
1. 一个总调度,一群并行的专家
/seo audit https://example.com
  └─ seo(总调度):先判断网站类型(SaaS、本地商家、电商、媒体、代理机构)
      ├─ 并行派出:technical、content、schema、sitemap、performance、visual、geo
      ├─ 按条件加派:google(有 API 凭据)、local / maps(本地商家)、backlinks、
      │             cluster、sxo、drift(之前拍过快照)、ecommerce(电商)
└─ 汇总 → 健康分 + 按优先级排好的行动清单行动清单里每一条都写明依据是什么、依赖什么、怎么验证已经改好了,这一点比很多 SEO 工具的「报错列表」实用得多。单项命令(比如 /seo schema)不走全套,直接交给对应的子技能。
2. 三层分工:技能、智能体、脚本
技能:每个领域一份操作说明(
SKILL.md),主文件控制在 500 行以内,细节放在参考文档里需要时再读,省上下文。智能体:19 个专家,各自用合适的模型,比如内容和 GEO 用 Opus,技术检查用 Sonnet。
脚本:一批 Python 脚本负责可复现的事实检查:解析页面标签、发现 sitemap、用各家 AI 爬虫的身份去访问、调 PageSpeed、校验 JSON-LD……模型负责判断和改代码,事实由脚本拿,结论不靠模型猜。
3. 两个我很喜欢的设计
改完自动校验:插件带了一个 Hook,Claude Code 每次编辑或写入文件后,自动跑一遍 JSON-LD 校验,结构化数据写错当场就会发现。
抓取有安全层:所有网络请求都经过固定 DNS 的地址检查,拒绝内网地址和本机代理,防止被诱导去访问内网(SSRF)。代价是它不检查本机地址,要等网站上线;在国内开着代理还会踩坑,见第六部分。
4. 扩展
可以接 DataForSEO、Ahrefs、SE Ranking、Profound、Bing Webmaster、Firecrawl、Unlighthouse、Matomo 等,拿关键词、外链、AI 引用份额这些数据,需要各自的账号或 API Key。不接扩展,核心检查照样能用。
五、实战:apsdeck.com 从「搜不到」到「被 AI 引用」
APS Deck 是我做的 AI 演示稿工具。在线版上线第一天,对用户是好的,对搜索引擎几乎是一片空白。
1. 查出了什么
| 查出的问题 | 后果 | 怎么改的 |
|---|---|---|
| 页面没有 description、canonical、分享卡片和结构化数据 | Google 自己猜摘要;链接发到 X 上没有大图 | 每个公开页面补齐标题、描述、canonical、Open Graph 和 X 卡片;每种语言一张 1200×630 的分享图 |
robots.txt、sitemap.xml 被跳转到登录页 | 爬虫拿不到抓取规则和页面清单 | 两个地址对外开放;sitemap 只列五个公开页面 |
| 三种界面语言共用一个地址,按 Cookie 和浏览器语言显示 | 爬虫没有 Cookie,只看得到简体中文 | 每种语言一个地址(?lang=en、?lang=zh-Hans、?lang=zh-Hant),hreflang 互相标注,不带参数的作为 x-default |
| 不存在的地址也跳转到登录页 | 软 404 | 只有工作区要登录,其他不存在的地址返回真正的 404 |
| 首页 HTML 256 KB:示例图片用 base64 写进页面,整个界面的文案也一起塞了进去 | 首屏慢,爬虫要下载一堆用不上的内容 | 图片改成单独的、能缓存的地址,文案只给页面用到的几组,降到 84 KB |
| 分享链接、邀请链接没有标记不收录 | 私人内容有被收录的风险 | 响应头加 X-Robots-Tag: noindex |
| 品牌名撞车:搜「APS AI presentation」全是另一个也叫 APS 的产品,搜「apsdeck」什么都没有 | 用户找不到,AI 也容易认错 | 标题、分享卡片、结构化数据统一写「APS Deck」,和域名对上,别名写 APS、apsdeck |
2. 几个关键决定
只公开 5 个页面:首页、价格、服务条款、隐私政策、退款政策。其余页面默认 noindex。
每种语言一个地址:地址里的
?lang=优先于 Cookie,站内链接也带上它,爬虫顺着链接就能找到每种语言的版本。这里踩了个坑:项目里/new?lang=本来就有别的意思(新演示稿的内容语言),所以只让公开页面的?lang=决定界面语言。结构化数据:Organization、WebSite、WebPage、SoftwareApplication(订阅和一次性时长包,共 4 个报价)、BreadcrumbList。不写 FAQPage,不编评分。
答案直接写在页面上:首页加了 6 条常见问题(是什么、要不要自带模型、多少钱、能导出什么、支持哪些语言、数据放在哪),每条第一句就是结论。
放行 AI 爬虫:robots.txt 单独列出 10 个 AI 爬虫;
/llms.txt从常见问题和价格配置自动生成。
3. 怎么证明改对了
自动化测试:单元测试加端到端测试,覆盖每个公开页面、每种语言的 canonical、hreflang、分享卡片和结构化数据,robots.txt、sitemap、llms.txt 的内容,不存在的地址返回 404,登录页和私密链接不被收录,首页 HTML 不超过 150 KB。以后谁改坏了,测试会直接报出来。
上线后对线上复测(用 claude-seo 的脚本):sitemap 里 17 个页面全部 200,结构化数据 17/17 通过校验;用 GPTBot、OAI-SearchBot、ClaudeBot、Claude-SearchBot、PerplexityBot 等身份访问全部 200,拿到的内容和浏览器一样;llms.txt 符合 Lighthouse 的规则;不存在的地址是真正的 404。
4. 提交和结果
Google Search Console:添加「网域」资源,在 Cloudflare 加一条 TXT 记录验证,提交
sitemap.xml,再用「网址检查」对首页和价格页「请求编入索引」。Bing Webmaster Tools:从 Search Console 一键导入,在 URL Submission 里一次提交 5 个地址。
结果就是开头那张图:提交后不到一天,Google 已经收录,标题是改过的「APS Deck · 面向讲师和创作者的 AI 演示稿编辑器」,AI 回答直接引用了网站的介绍、功能和价格表。Bing 还在排队,新域名一般要几天到两周。
详细步骤写在上一篇的「提交给搜索引擎」一节里。
六、踩过的坑(国内开发者尤其注意)
开着代理跑 claude-seo,检查结果全是失败。代理的 TUN 模式会把域名解析成
198.18.x.x的假地址,claude-seo 的安全层把它当成内网直接拒绝;HTTP_PROXY指向127.0.0.1,也被拒。解法:用 DNS-over-HTTPS 查到真实地址,给插件的 Python 加一个启动时替换解析结果的小钩子,再去掉代理环境变量运行(连接本身仍然走代理的 TUN):# sitecustomize.py:放在一个目录里,运行插件时把这个目录加进 PYTHONPATH import os, socket ips = os.environ['REAL_IPS'].split(',') # 用 DNS-over-HTTPS 查到的地址 _orig = socket.getaddrinfo def _patched(host, port, *args, **kwargs): if host in ('apsdeck.com', 'www.apsdeck.com'): return [(socket.AF_INET, socket.SOCK_STREAM, 6, '', (ip, 443)) for ip in ips] return _orig(host, port, *args, **kwargs) socket.getaddrinfo = _patched真实地址这样查:
curl -s -H 'accept: application/dns-json' 'https://cloudflare-dns.com/dns-query?name=apsdeck.com&type=A'。PageSpeed Insights 报「rate limit exceeded」:不配 API Key 时大家共用一个免费配额,经常被用光。直接在浏览器里打开 pagespeed.web.dev 测,或者给插件配一个自己的 Google API Key。
dig @1.1.1.1超时:代理拦了直连 DNS。同样用上面的 DNS-over-HTTPS 查 TXT 记录(把type=A换成type=TXT)。Bing 显示「Not discovered」:新域名的正常状态,提交就行。URL Inspection 页面下面的列表只是「查看过的记录」,不代表已经提交。
品牌名撞车:「APS」这种缩写在搜索引擎里有太多同名的东西。和域名一致的品牌写法(APS Deck)加别名,是最省事的办法。
切换语言后,页面变了、菜单还是旧语言:Next.js 的
router.replace只重新渲染页面这一段,根布局里的<html lang>和语言菜单留在旧语言。地址里带语言参数的页面,改成整页打开新地址。
七、和传统 SEO 工具比,适合谁
| claude-seo | Ahrefs、Semrush 这类 SaaS | |
|---|---|---|
| 价格 | 插件免费,用你自己的 Claude Code 额度 | 每月 $100 起 |
| 数据在哪 | 自己电脑上 | 对方的云端 |
| 能不能直接改代码 | 能,Claude Code 照着报告改,还能写测试 | 不能,只给报告 |
| 关键词、外链数据库 | 要接付费扩展(DataForSEO 等) | 自带海量数据 |
| AI 搜索(GEO) | 有专门的检查,跟着 Google 最新说法走 | 各家进度不一 |
适合有代码仓库、用 Claude Code 的独立开发者和小团队:技术 SEO、结构化数据、多语言、GEO 这些「改代码就能解决」的问题,它的效率很高。不适合单独拿来做关键词研究和竞品外链分析,这部分还是需要 Ahrefs、Semrush 这类数据,或者接它的 DataForSEO 扩展。还有一点要清醒:它不会替你写出好内容,品牌被提到、外链这些,也得自己去争取。
常见问题
claude-seo 是什么?免费吗?
claude-seo 是给 Claude Code 用的开源 SEO 和 GEO 插件,MIT 协议,插件本身免费,运行时消耗你自己的 Claude Code 额度。v2.5.0 有 26 个子技能、19 个子智能体和 30 条命令,覆盖技术 SEO、内容质量、结构化数据、AI 搜索、本地商家和电商。
怎么安装 claude-seo?
在 Claude Code 里运行 /plugin marketplace add AgriciDaniel/claude-seo 和 /plugin install claude-seo@agricidaniel-claude-seo,再运行 /seo setup 准备好独立的 Python 环境和 Chromium,然后用 /seo audit <网址> 检查网站。
GEO 和 SEO 有什么区别?
SEO 让搜索引擎能抓取、能理解、愿意排名;GEO 让 AI 搜索能读到、能理解、愿意引用。Google 的官方说法是为生成式 AI 搜索做优化仍然是 SEO;GEO 多出来的主要是:放行 AI 搜索爬虫、服务端渲染、把答案写成能单独引用的段落、写明作者日期和出处。
llms.txt 要不要做?
可以做,但别指望它。Google 表示搜索不使用 llms.txt,claude-seo 也不给它算分。它的成本很低,最好从现有页面内容自动生成,避免和页面说法不一致。
还要不要加 FAQPage 结构化数据?
不用。按 claude-seo 引用的 Google 说明,2026 年 5 月 7 日起所有网站的 FAQ 富媒体结果都不再展示。把问答直接写在页面正文里,对用户和 AI 搜索更有用。
新网站多久能被 Google 收录?
提交 Search Console、对首页「请求编入索引」的话可以很快:apsdeck.com 不到一天就被收录,Google 的 AI 回答也开始引用。不提交就只能等 Google 自己发现,可能要几天到几周;Bing 一般更慢。
为什么 claude-seo 检查我的网站全部失败?
先看两种情况:一是检查的是本机或内网地址,claude-seo 出于安全不检查,要等网站上线;二是在国内开着代理的 TUN 模式,域名被解析成 198.18.x.x 的假地址被当成内网拒绝,用 DNS-over-HTTPS 查到真实地址、去掉代理环境变量再跑。
怎么让 ChatGPT 搜索引用我的网站?
robots.txt 放行 OAI-SearchBot;把网站提交给 Bing Webmaster Tools(ChatGPT 的搜索有一部分用到 Bing 的索引);页面服务端渲染;把关键事实写成第一句就是结论的段落和常见问题。
写在最后
如果你也在用 Claude Code 做产品,强烈推荐装上 claude-seo:它把一个 SEO 顾问的检查清单变成了可以直接执行、直接改代码的工作流,我这次从体检、改代码、写测试到提交搜索引擎的每一步,都是和 Claude Code 在对话里一起完成的。觉得好用的话,去 GitHub 给作者点个 Star。
最后,再推荐一下我的产品 APS Deck:把讲稿、笔记或文章变成一套能逐页修改的演示稿。AI 先问你几个关于听众和目的的问题,列出大纲,再一页页做成 HTML 演示稿;可以在网页里放映、生成分享链接,或者导出 PDF 和可编辑的 PPTX。模型用你自己的 API Key,或者直接连 ChatGPT、GitHub Copilot 订阅。
新注册免费试用 14 天,不用绑卡;
上线优惠:年付订阅首年 5 折,只要 $20。在设置页订阅年付时,收银台输入优惠码
3GXZS7NE,2026 年 11 月 30 日前有效,限前 500 份。扣掉手续费每月只剩一块五美元左右,基本就是成本价,想请大家先用起来、多提意见。(订阅只能用银行卡、Apple Pay 或 Google Pay;想用微信付,可以买一次性时长包。)
👉 体验地址:https://apsdeck.com